Le cauchemar absolu de tout réalisateur travaillant avec l'intelligence artificielle générative a toujours été la «loterie du Text-to-Video (T2V)»: rédiger un prompt détaillé et prier pour que le modèle devine l'angle exact de la caméra, la nuance d'un regard ou la physique d'un coup de pied martial. En septembre 2026, cette époque est définitivement révolue. La révolution du Vidéo-vers-Vidéo (V2V) et du Neural Motion Transfer permet à tout créateur d'utiliser une simple vidéo smartphone de 5 secondes comme «squelette cinétique». Les modèles de diffusion spatio-temporelle (Seedance 2.0 IR2V et Wan 3.0) extraient la trajectoire de caméra, la carte de profondeur métrique et le flux optique de votre tournage brut, remplaçant la peau, le décor, les costumes et l'éclairage par des textures cinématographiques 4K au rendu anamorphique 35mm. Ce qui nécessitait auparavant 15 000€ de combinaisons de capture de mouvement (MoCap) et des semaines de modélisation 3D sur Maya s'exécute désormais en moins de 3 minutes sur DXBuilder Video Studio pour moins de 0,85€ de calcul GPU.
Définition Technique: Vidéo-vers-Vidéo Neural (V2V) et Motion Transfer en 2026
Le Vidéo-vers-Vidéo Neural (V2V) est une architecture générative conditionnelle dans laquelle une vidéo préexistante fournit le guidage structurel spatio-temporel (flux optique, vecteurs de vitesse, cartes de profondeur monoculaire via Depth Anything V2 et segmentation de contours denses via SAM 3) à un modèle de diffusion à transformateurs (DiT). Au lieu de synthétiser le mouvement à partir d'un bruit latent aléatoire guidé uniquement par du texte, le V2V réinjecte la dynamique physique du monde réel image par image dans l'espace latent. Cela permet aux cinéastes de ré-éclairer des scènes, de changer les costumes, de transfigurer des acteurs en créatures fantastiques ou d'exécuter des cascades complexes avec 100% de cohérence temporelle.
1. La Fin de la «Loterie du Prompt»: Pourquoi le Text-to-Video Échoue en Réalisation Professionnelle
Si vous avez déjà tenté de créer un plan cinématographique complexe en utilisant uniquement des mots dans une boîte de prompt, vous connaissez cette immense frustration. Vous tapez: «Travelling rapide en contre-plongée suivant un guerrier qui saute par-dessus des gravats, tournoie dans les airs et atterrit katana en main sous un éclairage ambré». Vous cliquez sur générer.
Au premier essai, le personnage a trois jambes. Au deuxième, la caméra zoome inexplicablement vers le ciel. Au dixième essai, le mouvement est fluide mais le guerrier semble flotter sans aucune gravité terrestre. Après 40 générations et 30€ de crédits brûlés, vous acceptez un compromis médiocre très éloigné de votre vision.
La raison technique est limpide: les modèles de diffusion vidéo excellent dans le rendu des matières, du brouillard volumétrique et du grain optique, mais ne possèdent aucune intuition spatiale concernant le placement des acteurs (blocking) ou la vitesse de rotation de la caméra. Le vrai cinéma repose sur des micro-décisions de quelques millisecondes. Tenter de décrire cela par du texte revient à vouloir dicter une symphonie de Beethoven au téléphone.
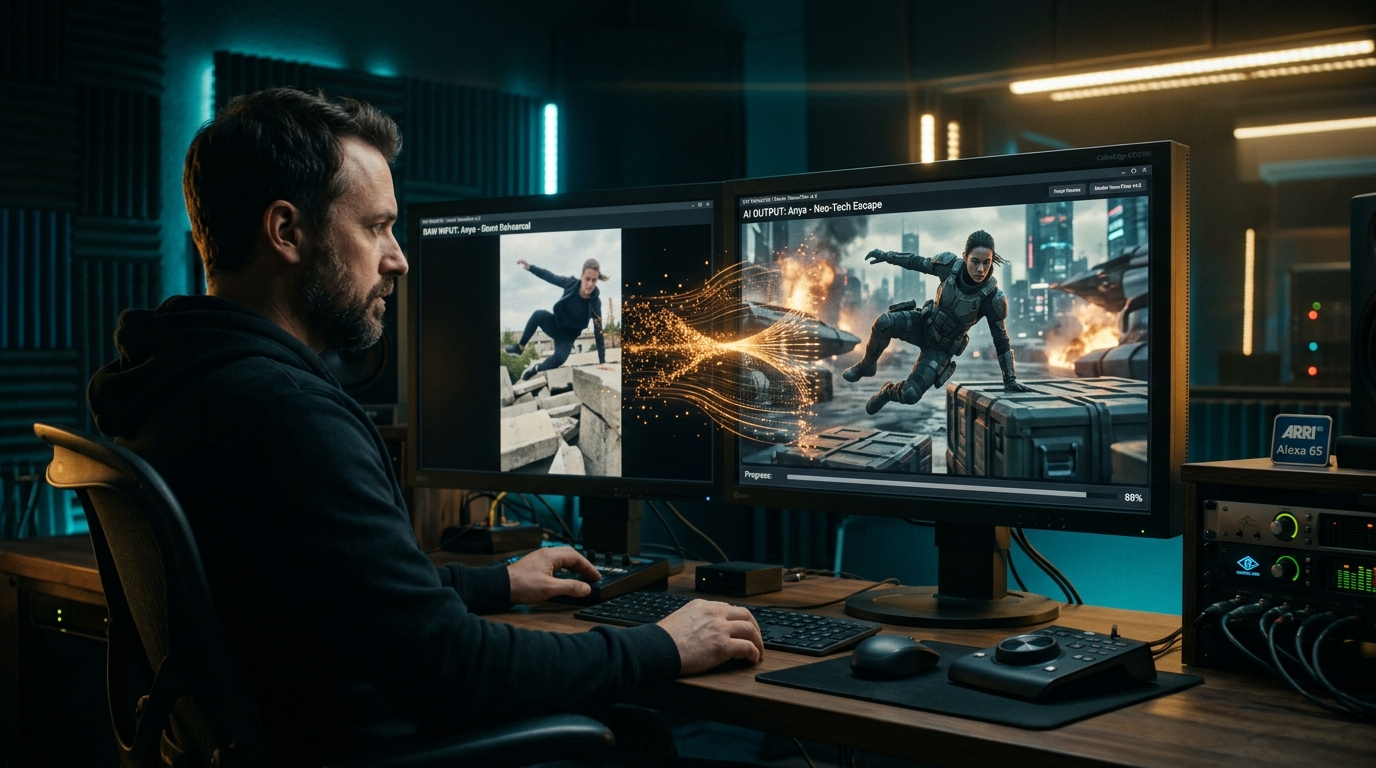
C'est ici que le Vidéo-vers-Vidéo (V2V) change la donne. Au lieu d'expliquer les lois de la physique à l'algorithme, vous prenez votre smartphone, sortez dans votre salon ou votre rue, effectuez le mouvement ou bougez la caméra au rythme exact souhaité. Cette vidéo de référence devient l'armature cinétique indestructible sur laquelle l'IA applique son rendu visuel.
2. Fonctionnement Technique du V2V en 2026: La Triade de Guidage
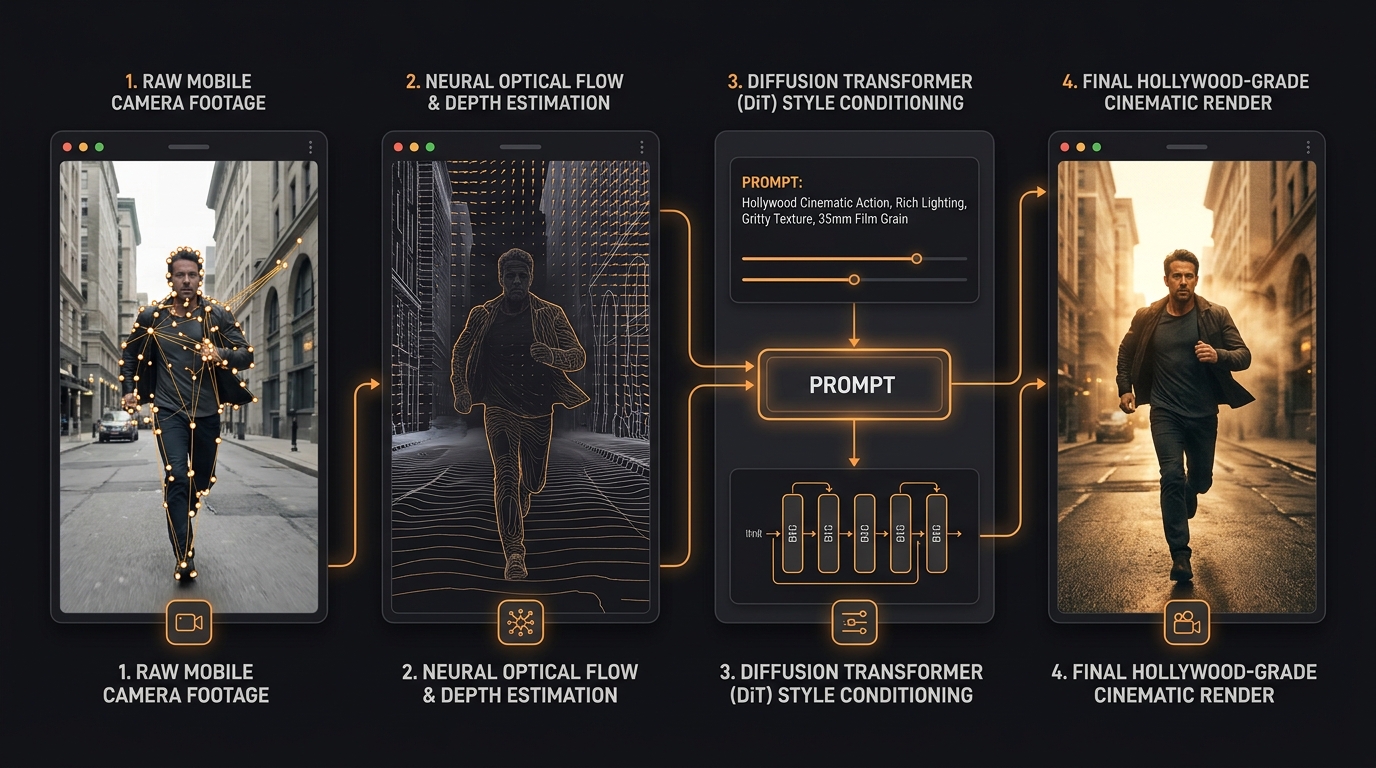
En téléchargeant une vidéo de référence sur le Video Studio de DXBuilder avec les moteurs Seedance 2.0 IR2V ou Wan 3.0 V2V, trois étapes de déconstruction mathématique se déclenchent instantanément:
Calcul de la distance relative de chaque pixel par rapport à la lentille virtuelle. Cela génère un maillage 3D volumétrique, empêchant les éléments d'arrière-plan de fusionner avec les acteurs.
Suivi précis de la vitesse de chaque membre et de la caméra d'une image à l'autre, permettant à l'IA de synthétiser un flou de mouvement (motion blur) organique parfait.
Le transformateur de diffusion remplace l'apparence visuelle originale par l'esthétique de votre prompt tout en intégrant vos ancrages d'acteurs issus du Character Studio (@Hero).
3. Le Guide Pratique: Du Smartphone au Master 4K
1 Le Tournage du Rush Témoin
Un smartphone filmant en 1080p ou 4K à 60 i/s est idéal. Retenez ces trois règles:
- Vitesse d'Obturation Élevée: Réduisez le flou de bougé natif de votre capteur mobile afin que le modèle de flux optique puisse isoler les doigts et les mouvements rapides sans artefact.
- Contraste des Vêtements: Portez des vêtements qui tranchent nettement avec le décor pour faciliter le détourage automatique sans fond vert.
- Mouvements de Caméra Organiques: Marchez physiquement vers l'acteur pour créer un travelling dramatique. L'inertie humaine naturelle apporte une authenticité impossible à feindre par prompt textuel.
2 La Règle d'Or du Prompting V2V: Décrire l'Esthétique, Jamais le Mouvement
Ne faites jamais l'erreur d'importer une vidéo de course et d'écrire: «Un homme court vers la gauche en regardant derrière lui». L'IA extrait déjà cette action du flux vidéo. Votre texte doit se concentrer uniquement sur la lumière, les matériaux et la direction artistique:
4. Comparatif Technique: La Révolution des Méthodes
| Métrique de Production | Text-to-Video Pur (T2V) | CGI 3D & MoCap Traditionnel | AI Video-to-Video (V2V) |
|---|---|---|---|
| Contrôle de Caméra | Aléatoire (30 à 40 essais par plan) | Manuel absolu sous Maya ou Blender | Déterministe 1:1 calqué sur le mouvement réel du smartphone |
| Physique Corporelle | Membres surnuméraires et apesanteur non voulue | Nécessite capteurs optiques et nettoyage complexe | Physique anatomique réelle préservée directement |
| Délai de Livraison | 2 à 4 heures d'itérations répétitives | 3 à 6 semaines de production 3D | 90 à 180 secondes sur le cluster GPU DXBuilder |
| Coût par Plan | 15€ à 35€ en crédits gaspillés | 8 000€ à 25 000€ en studio et équipe | 0,80€ à 1,50€ en crédits DXBuilder |
5. Foire Aux Questions (FAQ)
Faut-il une caméra professionnelle pour la vidéo témoin?
Non. N'importe quel smartphone des quatre dernières années filmant en 1080p ou 4K suffit amplement. L'IA n'utilise pas la qualité de texture de votre téléphone, mais uniquement les vecteurs d'accélération et le maillage spatial.
Quel est le coût comparé au Text-to-Video classique?
Le coût GPU par plan est quasi identique (0,80€ à 1,20€ avec Seedance 2.0 IR2V), mais le coût global de production est plus de 80% inférieur car vous évitez des dizaines de prises ratées. Découvrez nos offres sur la page Tarifs DXBuilder.
Rédigé par Filipe Heitor
Fondateur et Directeur Créatif de DXBuilder
Engagé dans la conception d'outils d'IA générative rendant le plein contrôle créatif aux cinéastes indépendants. Testez notre Video Studio, structurez vos récits sur le Story Lab et verrouillez vos acteurs dans le Character Studio.