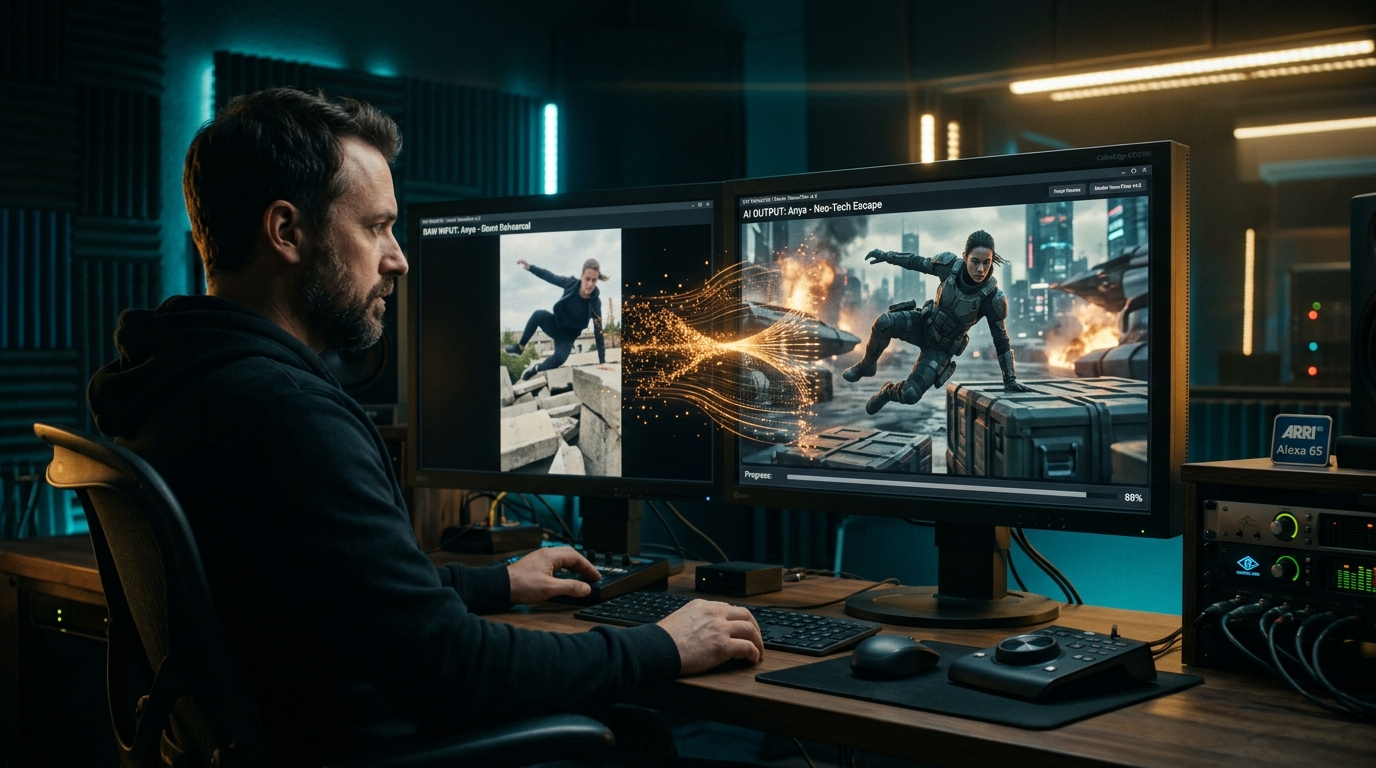
对于采用生成式AI制作视频的创作者与导演而言,最大的痛点莫过于「文生视频(Text-to-Video,T2V)的抽奖困境」:输入一段详尽的提示词,然后祈祷模型能够正确猜中运镜角度、人物眼神的停顿或武术动作的物理真实感。而在2026年9月,这一低效模式已彻底成为历史。视频到视频(Video-to-Video,V2V) 与 神经动态迁移(Neural Motion Transfer) 的革命,让任何创作者只需用智能手机拍摄5秒钟的草稿视频,即可作为AI的「动力学骨骼」。新一代时空扩散变压器模型(Seedance 2.0 IR2V 与 Wan 3.0)能够直接从手机拍摄中提取摄影机运动轨迹、单目深度图及光流加速度,将其瞬间替换为具备35mm变形宽银幕电影质感的4K画面。过去需要15,000欧元的动捕服和数周3D软件绑定的镜头,如今在 DXBuilder Video Studio 中仅需不到3分钟、不足0.85欧元的算力成本即可完成。
技术定义:神经视频到视频(V2V)与动态迁移(2026版)
神经视频到视频(Neural V2V) 是一种条件生成架构,其中预先录制的参考视频为扩散变压器(DiT)提供结构性时空引导(光流、速度向量、通过 Depth Anything V2 生成的度量深度图以及通过 SAM 3 进行的稠密轮廓跟踪)。与仅依赖文本从纯粹随机潜空间噪声中合成动作不同,V2V 将真实世界的物理运动逐帧注入潜空间。这使得导演能够以100%的时空连贯性和零解剖学形变,自由重构光影、更换服装、转换角色面孔或实现复杂的动作特技。
1. 告别「抽奖式提示词」:为什么纯文生视频无法满足专业影视导演的要求
如果你曾尝试仅依靠提示词文本框生成一段复杂的打斗动作,一定深知其中的挫败感。无论如何描述镜头推拉或人物起跳,模型往往会导致肢体变形、浮空失重或镜头莫名摇摆。导演的本质是精准调度(Blocking)与惯性节奏,而文字在表达这毫秒级的物理动态时显得极度贫乏。
视频到视频(V2V) 从根本上打破了这种僵局。你只需拿起手机在客厅或室外自己走一遍位、甩动镜头,这段手机素材便构成了不可动摇的物理力学基底,AI 则专注于发挥其在材质、灯光与视觉美学上的无限能力。
2. 2026年 V2V 技术内核:三大时空解构通道
计算画面中每个像素相对于虚拟镜头的精准距离,构建三维立体点云,杜绝前后景穿模融合。
追踪人物肢体与运镜的毫秒级速度矢量,确保生成的光学运动模糊(Motion Blur)完全符合现实运动学规律。
在保留运动骨架的前提下,通过 Character Studio (@Hero) 将原始外观替换为高精度的影视角色皮肤与服装。
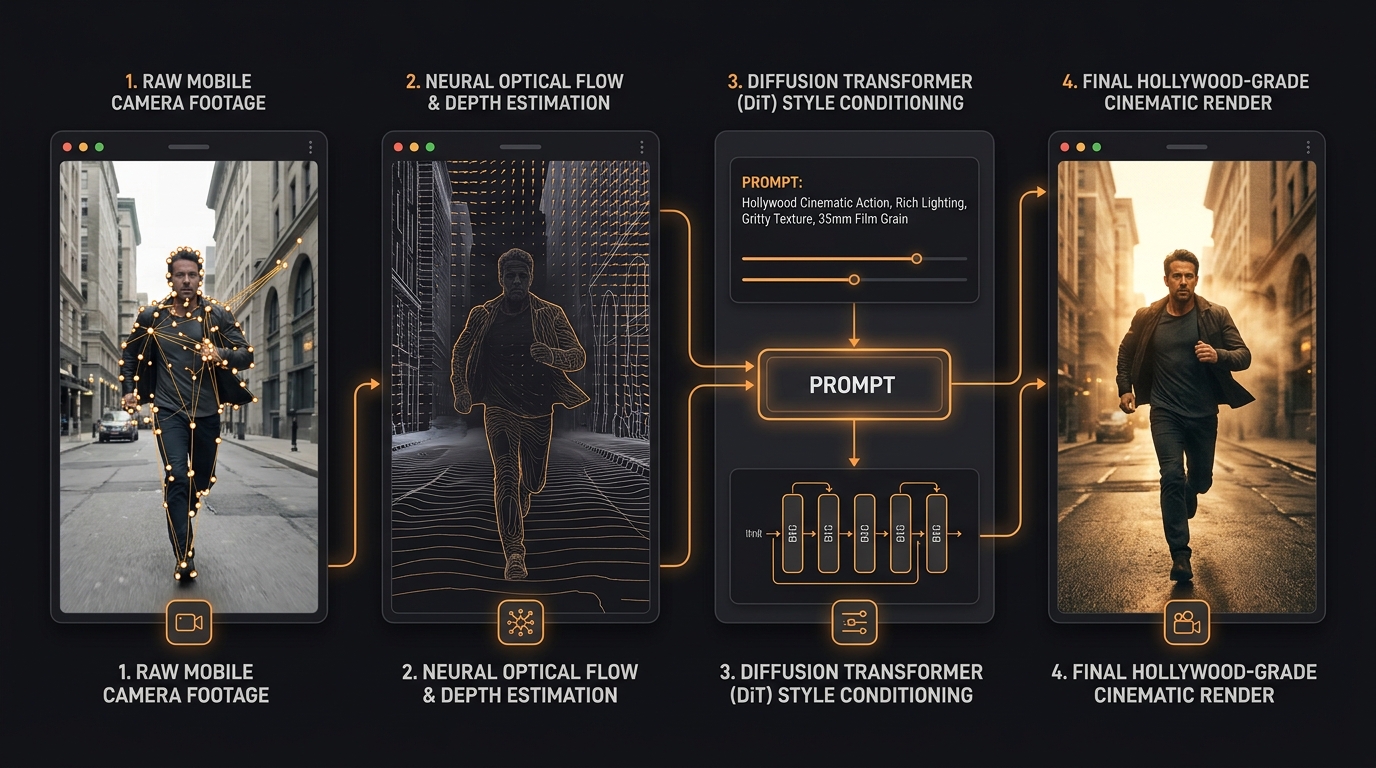
3. V2V 提示词黄金法则:专注视觉风格,绝不重复描述动作
新手最常犯的错误是上传跑步视频并在提示词中重复写「一个男人向左奔跑并回头」。模型已在视频像素中提取了动作,文字重复描述会导致模型产生冲突并生成多余肢体。你的提示词只需专注于美术指导、材质与光影氛围:
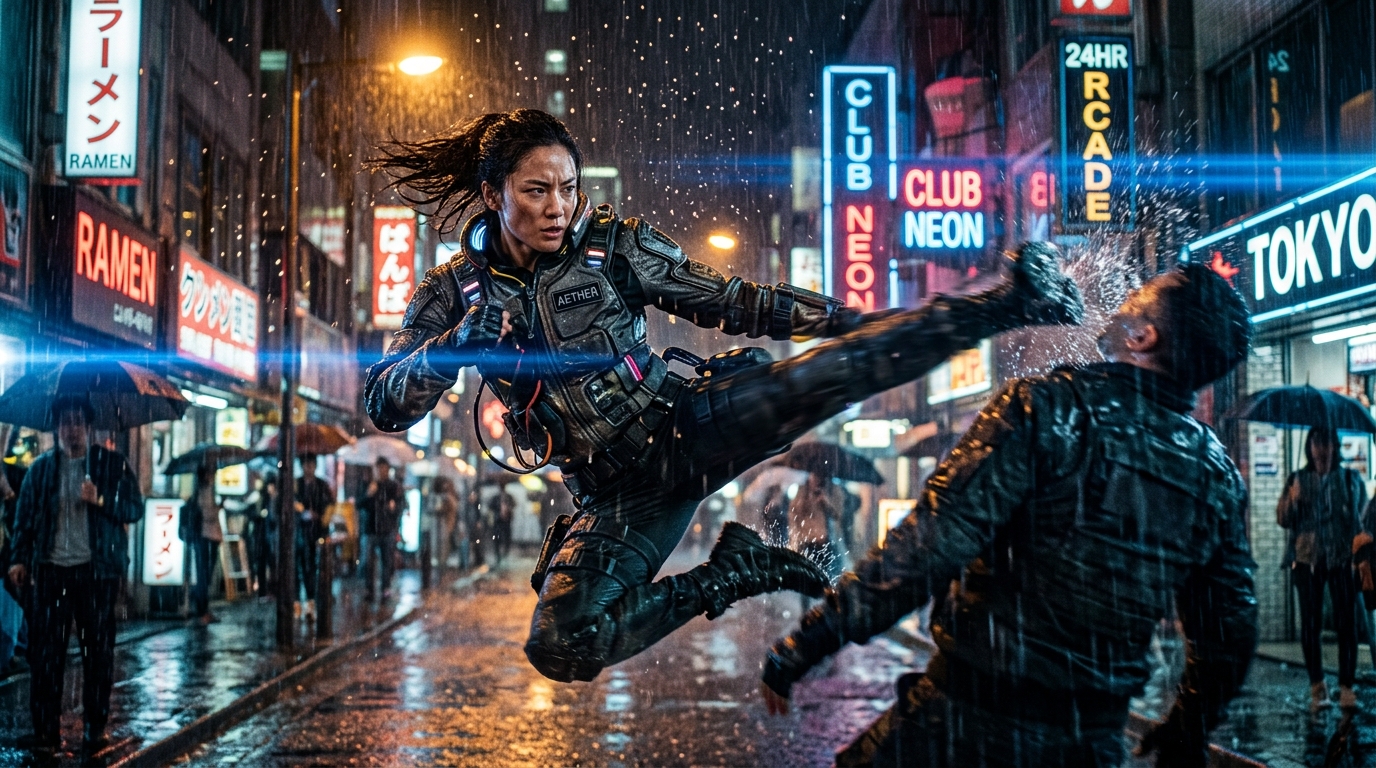
4. 2026年三大影视制作技术横向对比
| 指标 | 纯文本生视频 (T2V) | 传统 3D CGI 与动捕 | AI 视频到视频 (V2V) |
|---|---|---|---|
| 运镜精准度 | 随机抽签(需重复生成数十次) | 三维软件内手动关键帧调整 | 1:1 精准复刻手机实际物理运动 |
| 单镜头交付周期 | 2至4小时反复重试 | 3至6周(绑定、动画、解算) | DXBuilder 集群仅需 90 至 180 秒 |
| 单镜头综合成本 | 15至35欧元浪费在无效算力上 | 8,000至25,000欧元场地与人工 | 仅需 0.80 至 1.50 欧元的算力点数 |
5. 常见问题解答 (FAQ)
录制参考视频需要昂贵的专业摄影机吗?
完全不需要。近四年内生产的任何支持1080p或4K的智能手机均可完美胜任。模型不采集手机的像素纹理,而仅提取其运动矢量和三维空间深度。
相比纯文生视频,综合制作成本如何?
由于省去了数十次因镜头运动失准导致的废片,整体制作开销降低80%以上。详细定价请参考 DXBuilder 价格方案。
撰文:Filipe Heitor
DXBuilder 创始人兼创意总监
致力于研发将真正的导演控制权归还给独立创作者的生成式AI工具。欢迎体验我们的 Video Studio、使用 Story Lab 编排剧作蓝图,并在 Character Studio 中锁定专属演员阵容。