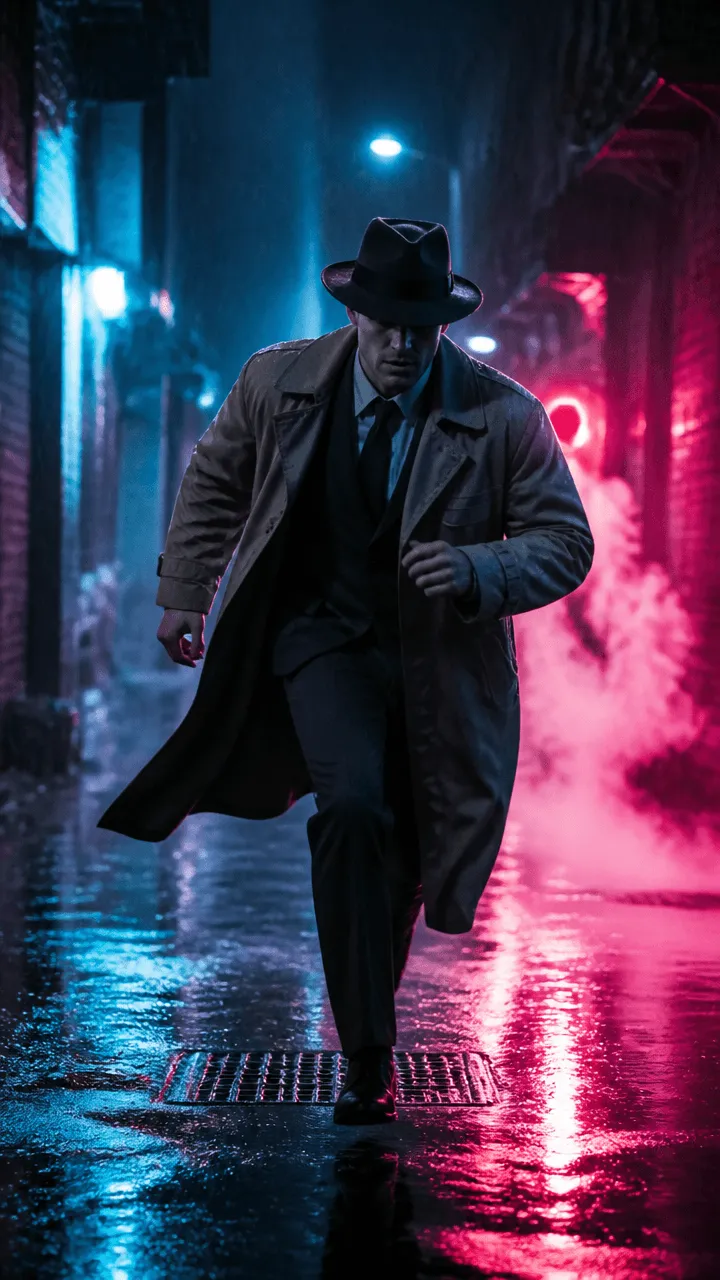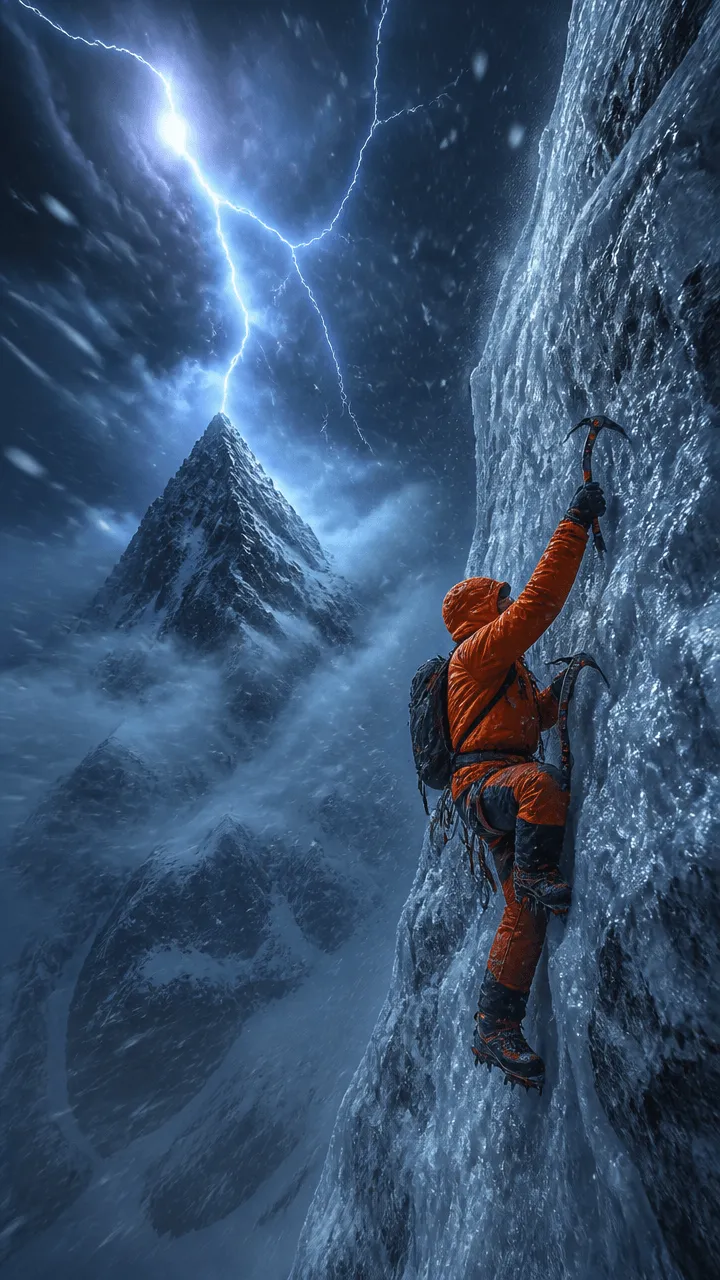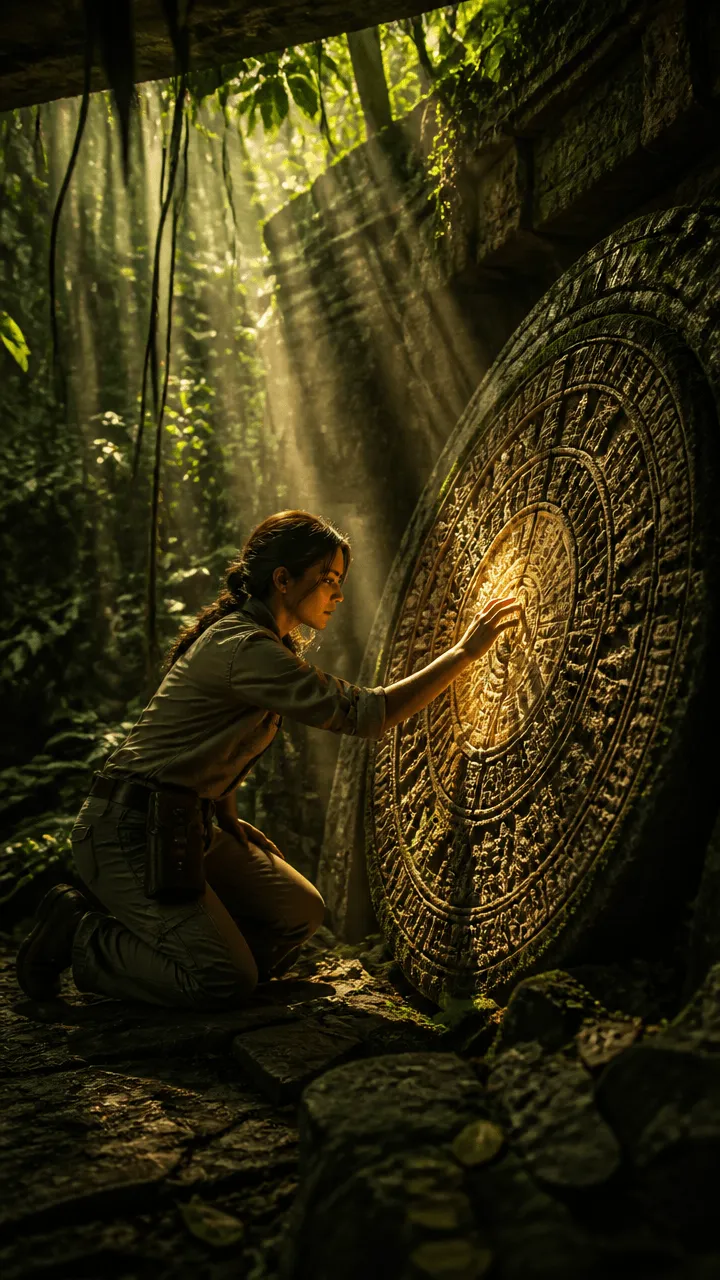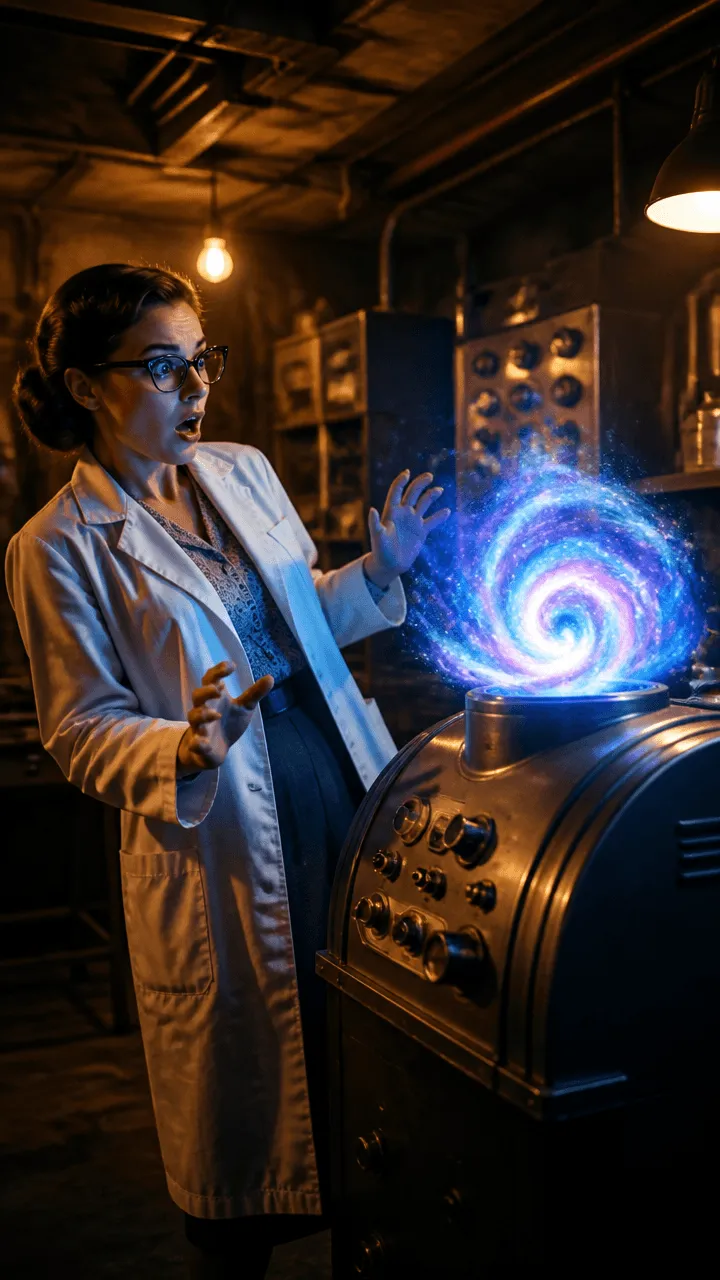
لطالما كان الكابوس الأكبر لكل مخرج يعمل مع الذكاء الاصطناعي التوليدي هو «يانصيب تحويل النص إلى فيديو (Text-to-Video)»: كتابة وصف دقيق والصلاة كي يخمن النموذج الزاوية المطلوبة أو الإيقاع الحركي للقطة بدقة. في سبتمبر 2026، انتهى هذا العهد رسمياً. ثورة تحويل الفيديو إلى فيديو (V2V) والنقل الحركي العصبي (Neural Motion Transfer) تتيح اليوم لأي مخرج استخدام مقطع مصور بالهاتف مدته 5 ثوانٍ كـ«هيكل حركي» متماسك. تقوم نماذج الانتشار الزمكاني المتطورة (Seedance 2.0 IR2V و Wan 3.0) باستخراج مسار الكاميرا، خرائط العمق الحجمية والتدفق البصري من هاتفك الذكي، مستبدلة البشرة والملابس والإضاءة بخامات سينمائية فائقة الدقة 4K بعدسات أنامورفيك 35 ملم. ما كان يتطلب 15,000 يورو لبدلات التقاط الحركة وأسابيع من النمذجة في استوديوهات 3D، يتم إنجازه الآن في أقل من 3 دقائق على DXBuilder Video Studio بتكلفة تقل عن 0.85 يورو من حسابات المعالجة.
التعريف التقني: الفيديو العصبي (Neural V2V) ونقل الحركة في 2026
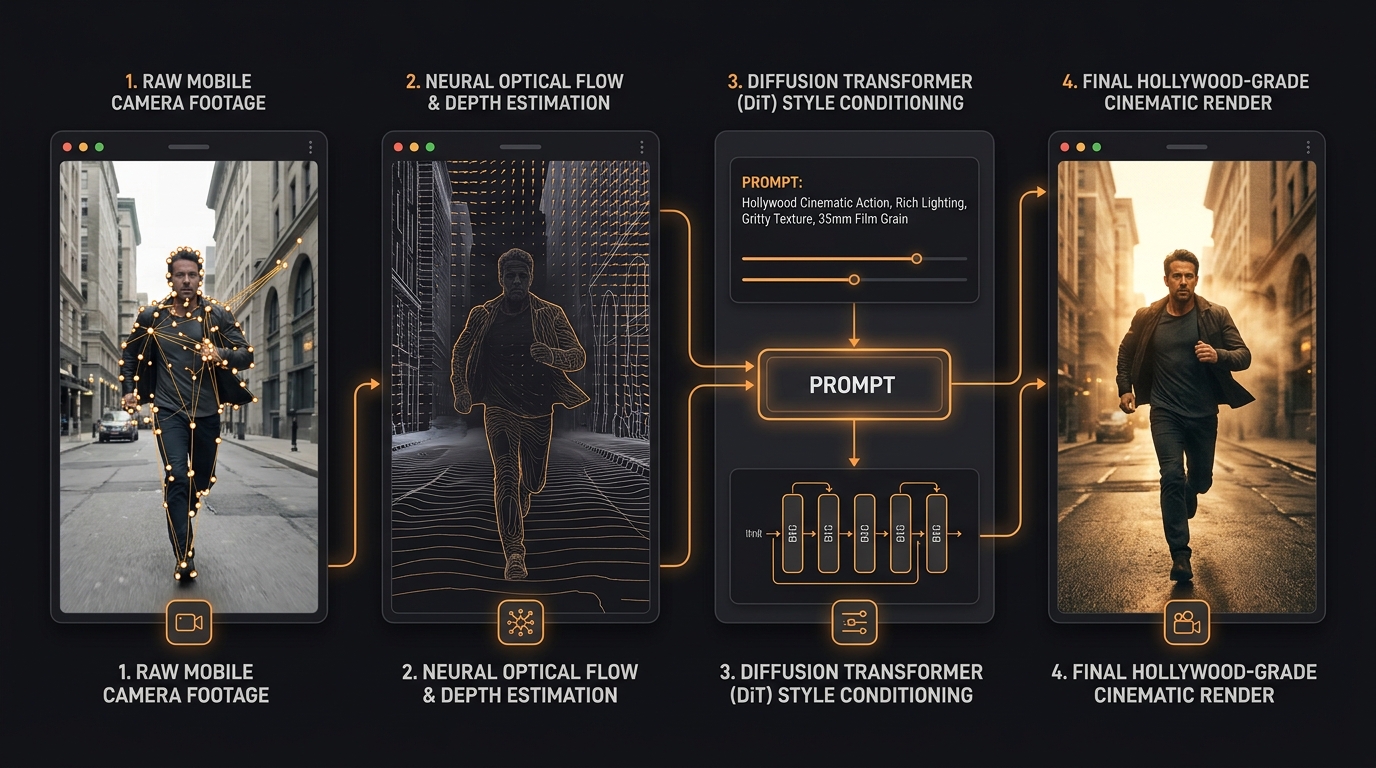
تحويل الفيديو إلى فيديو العصبي (Neural V2V) هو بنية توليدية شرطية يقدم فيها مقطع فيديو مرجعي التوجيه الهيكلي والزمكاني (التدفق البصري، متجهات السرعة، تقدير العمق عبر Depth Anything V2 وتتبع الحدود الكثيفة عبر SAM 3) لنموذج انتشار المحولات (DiT). بدلاً من تخمين الحركة انطلاقاً من ضوضاء عشوائية بالاعتماد على الكلمات فقط، يعيد V2V حقن الفيزياء الواقعية إطاراً تلو الآخر في الفضاء الكامن، مما يمنح المخرج القدرة على إعادة إضاءة المشهد وتبديل الشخصيات والحفاظ على ثبات تشريحي وحركي بنسبة 100%.
1. نهاية يانصيب الوصف النصي: لماذا يفشل Text-to-Video في الإخراج الاحترافي
إذا جربت يوماً توليد مشهد أكشن معقد بالكلمات فقط، فأنت تعرف حجم الإحباط: تشوهات في الأطراف، كاميرا تقفز بلا مبرر نحو السماء، وممثل يبدو كأنه يسبح في انعدام الجاذبية. الإخراج السينمائي يعتمد على التوقيت والقصور الذاتي الدقيقين، وهي أمور يستحيل ضبطها بمجرد نص.
هنا تكمن قوة V2V: التقط هاتفك، تحرك في غرفتك أو فنائك بالسرعة والزاوية التي تريدها تماماً، وسيتولى الذكاء الاصطناعي إلباس هذا الهيكل الواقعي أروع الخامات السينمائية.
2. الهندسة الداخلية لتقنية V2V في عام 2026
حساب البعد الحجمي لكل بكسل عن العدسة الافتراضية لمنع تداخل الخلفية مع الممثل.
تتبع تسارع كل طرف وحركة الكاميرا لضمان واقعية ضبابية الحركة البصرية (Motion Blur).
إعادة رسم اللقطة وفقاً لمواصفات الإضاءة والممثل المعتمدة في Character Studio (@Hero).
3. القاعدة الذهبية لكتابة برومبت V2V: صف الجماليات ولا تصف الحركة
الخطأ الأكثر شيوعاً هو رفع فيديو لشخص يركض وكتابة: «رجل يركض نحو اليسار وينظر خلفه». الحركة مستخرجة بالفعل من الفيديو! ركز في وصفك على الديكور والمواد والإضاءة فقط:
4. مقارنة تقنيات الإنتاج في 2026
| معيار الإنتاج | النص إلى فيديو التقليدي (T2V) | الجرافيك 3D والتقاط الحركة القديم | فيديو إلى فيديو بالذكاء الاصطناعي (V2V) |
|---|---|---|---|
| التحكم بزاوية الكاميرا | عشوائي تماماً (30 محاولة للقطة الواحدة) | يدوي بالكامل عبر برامج 3D | مطابق 1:1 لحركة يدك بهاتفك المحمول |
| مدة إنجاز اللقطة | من 2 إلى 4 ساعات من التوليد المتكرر | من 3 إلى 6 أسابيع عمل استوديو | من 90 إلى 180 ثانية على سيرفرات DXBuilder |
| التكلفة لكل لقطة | 15€ إلى 35€ مهدرة في محاولات فاشلة | 8,000€ إلى 25,000€ فرق عمل واستوديوهات | 0.80€ إلى 1.50€ من رصيد DXBuilder |
5. الأسئلة الشائعة (FAQ)
هل أحتاج كاميرا سينمائية لتصوير الفيديو المرجعي؟
لا على الإطلاق. أي هاتف ذكي حديث يدعم 1080p أو 4K كافٍ تماماً؛ فالنموذج لا يستخدم دقة الكاميرا بل يستخرج متجهات الحركة وشبكة العمق فقط.
كم تبلغ التكلفة الإجمالية مقارنة بالتوليد النصي؟
التكلفة الإجمالية تنخفض بنسبة أكثر من 80% بفضل تجنب المحاولات الفاشلة لتوجيه الكاميرا. تفضل بزيارة صفحة باقات وأسعار DXBuilder.
بقلم: فيليبي هيتور (Filipe Heitor)
المؤسس والمدير الإبداعي لـ DXBuilder
أكرس جهودي لتطوير أدوات الذكاء الاصطناعي التي تعيد السيطرة الإخراجية الكاملة لصناع الأفلام المستقلين. جرب Video Studio، خطط لمشروعك في Story Lab، وثبّت ممثليك في Character Studio.