Der größte Albtraum jedes Regisseurs bei generativer KI war die «Text-to-Video (T2V) Lotterie»: Man tippt einen detaillierten Prompt ein und hofft verzweifelt, dass das Modell den Kamerawinkel oder das Timing eines Blicks errät. Im September 2026 ist dieses Paradigma endgültig überholt. Die Video-zu-Video (V2V) und Neural Motion Transfer Revolution ermöglicht es jedem Creator, einfache 5-Sekunden-Smartphone-Aufnahmen als kinetisches Skelett zu nutzen. Neueste Raum-Zeit-Diffusionsmodelle (Seedance 2.0 IR2V und Wan 3.0) extrahieren Kamerabewegung, Tiefenkarten und optischen Fluss direkt aus Amateuraufnahmen und rendern fotorealistisches 4K-Kino mit 35mm-Anamorphotik-Look. Was früher 15.000€ für MoCap-Anzüge und Wochen in Maya kostete, entsteht nun in unter 3 Minuten im DXBuilder Video Studio für unter 0,85€ GPU-Rechenzeit.
Technische Definition: Neural Video-to-Video (V2V) & Motion Transfer 2026
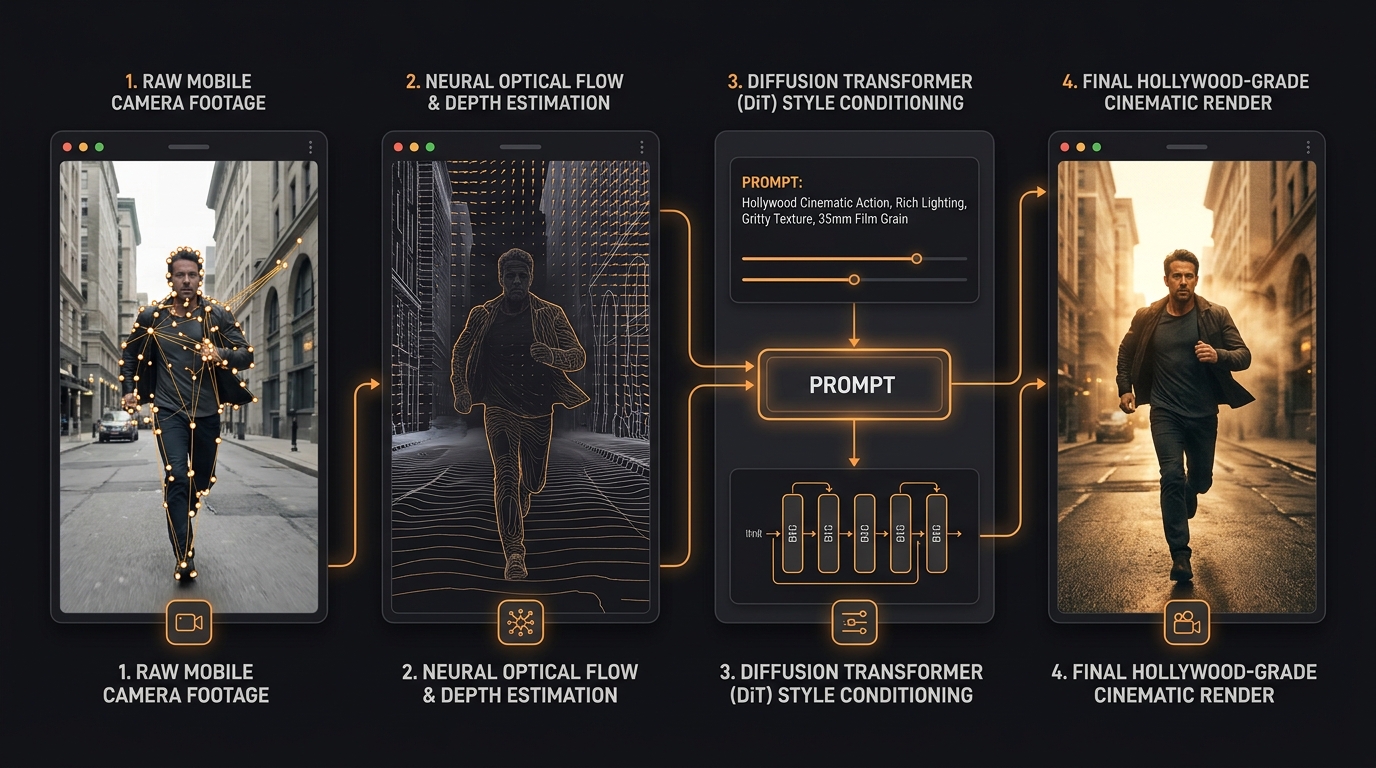
Neural Video-to-Video (V2V) ist eine bedingte generative Architektur, bei der ein existierendes Video strukturelle Orientierungsdaten (optischer Fluss, Geschwindigkeitsvektoren, Tiefenkarten via Depth Anything V2 und Segmentierung via SAM 3) für einen Diffusion Transformer (DiT) liefert. Anstatt Bewegung aus reinem Rauschen per Text zu erraten, injiziert V2V echte physikalische Dynamik Frame für Frame in den Latentspace. Dies erlaubt exakte Kameraführung, Umbeleuchtung und Charaktertausch bei 100% Bewegungskonsistenz.
1. Das Ende des Prompt-Roulettes: Warum Text-to-Video bei Action-Regie scheitert
Wer jemals eine komplexe Kampfszene nur per Textprompt erstellen wollte, kennt das Desaster: Gliedmaßen verschmelzen, Kameras springen willkürlich und Schauspieler schweben schwerelos. Filmregie lebt von Sekundenbruchteilen und Trägheit. Das lässt sich nicht in einem Textabsatz beschreiben.
Mit Video-zu-Video (V2V) nehmen Sie Ihr Smartphone, filmen sich selbst im Wohnzimmer oder Hof und bewegen die Kamera genau im gewünschten Rhythmus. Diese Aufnahme wird zum unzerstörbaren Bewegungsskelett für die KI.
2. Die V2V-Funktionsweise unter der Haube: Die Konditionierungs-Triade
Errechnet die Distanz jedes Pixels zur virtuellen Linse und verhindert das Verschmelzen von Vorder- und Hintergrund.
Verfolgt Beschleunigung und Bewegung jedes Körperteils, um präzise Bewegungsunschärfe (Motion Blur) zu rendern.
Ersetzt Kleidung und Umgebung basierend auf Ihrem Prompt und den Schauspieler-Ankern aus dem Character Studio (@Hero).
3. Die goldene Prompting-Regel bei V2V: Ästhetik beschreiben, niemals die Bewegung
Der häufigste Anfängerfehler: Ein Video einer rennenden Person hochladen und prompten: «Ein Mann rennt nach links». Die KI liest die Bewegung bereits aus den Pixeln. Ihr Prompt muss sich ausschließlich auf Beleuchtung, Material und Stil konzentrieren:
4. Technischer Methodenvergleich 2026
| Kriterium | Text-to-Video (T2V) | 3D CGI & MoCap | AI Video-to-Video (V2V) |
|---|---|---|---|
| Kamerakontrolle | Zufallsbasiert | Manuell in Maya/Blender | 1:1 exakt nach Smartphone-Führung |
| Produktionszeit pro Shot | 2–4 Stunden Neuversuche | 3–6 Wochen Studioarbeit | 90–180 Sekunden auf DXBuilder GPUs |
| Kosten pro Shot | 15€–35€ GPU-Verschwendung | 8.000€–25.000€ | 0,80€–1,50€ in DXBuilder Credits |
5. Häufig gestellte Fragen (FAQ)
Brauche ich eine teure Kamera für das Rohvideo?
Nein. Jedes moderne Smartphone mit 1080p oder 4K reicht völlig aus. Das KI-Modell nutzt nicht die Textur Ihres Handys, sondern ausschließlich Bewegungsvektoren und Tiefeninformationen.
Wie hoch sind die Kosten im Vergleich?
Die Gesamtkosten sinken um über 80%, da Fehlversuche bei Kamera und Timing entfallen. Tarife finden Sie auf der DXBuilder Preisseite.
Geschrieben von Filipe Heitor
Gründer & Creative Director von DXBuilder
Entwickelt generative KI-Tools, die Filmemachern die volle kreative Regiekontrolle zurückgeben. Testen Sie unser Video Studio, planen Sie Szenen im Story Lab und sichern Sie Darsteller-Identitäten im Character Studio.