Matriz de Decisão: Para Quem É (E Para Quem Não É)
| Ideal para (Best for) | Descarta ou espera se (Skip or wait if) |
|---|---|
| Marcas de comércio eletrónico, agências de tráfego pago e criadores de conteúdo que precisam de anúncios de 30 segundos completos para Reels, TikTok Shop e YouTube sem pagar 4.000€ a produtoras físicas. | Projetos que apenas necessitam de pequenas animações estáticas de 2 segundos para logótipos em websites institucionais. |
| Realizadores independentes e produtoras que pretendem criar planos-sequência fluidos, travellings de câmara complexos e cenas narrativas sem quebras de continuidade. | Equipas que insistem em digitar frases vagas de texto puro no modelo esperando que a IA adivinhe a iluminação, lentes e proporções do produto sem usar uma imagem âncora. |
| Profissionais de vídeo que querem poupar até 80% do tempo de edição eliminando a procura manual de bibliotecas de efeitos sonoros (SFX) e sincronização de Foley. | Operadores que ainda acreditam que instalar dezenas de modelos pesados em placas gráficas locais que consomem 800W é mais viável do que usar estúdios na nuvem. |
O Que Mudou em 2026: Por Que os Vídeos de 5 Segundos se Tornaram Obsoletos
Até há muito pouco tempo, quem tentava criar um comercial de vídeo com inteligência artificial enfrentava um pesadelo técnico: os modelos geravam apenas clips de 4 ou 5 segundos. Para fazer um anúncio de 30 segundos, o criador tinha de gerar 6 a 8 clips separados e tentar juntá-los num editor. O resultado? O rosto da personagem mudava, a garrafa do produto encolhia, o fundo transformava-se numa sala diferente e a iluminação oscilava bruscamente.
Em outubro de 2026, os motores de difusão de vídeo alcançaram a maturidade dos 30 segundos contínuos nativos. Modelos de referência como o Seedance 2.5 (ByteDance), o novo Kling 4.0 Flash (Kuaishou) e o Wan 3.0 (Alibaba) utilizam arquiteturas de transformadores de difusão (DiT) com janelas de atenção temporal alargadas que mantêm a física, a trajetória da câmara e a identidade do sujeito bloqueadas ao longo de toda a cena.
Seedance 2.5 IR2V
O líder incontestável para comerciais de produto e consistência multi-referência. Permite fornecer até 3 imagens de referência (produto, ator e ambiente), garantindo que rótulos, materiais metálicos e traços faciais se mantêm matematicamente intactos durante os 30 segundos.
Kling 4.0 Flash
Destaque absoluto em 4K HDR nativo com suporte a cores de 10-bit e controlo de até 10 keyframes de interpolação. Permite desenhar trajetórias de câmara complexas indicando onde a câmara deve estar aos segundos 0, 10, 20 e 30.
Wan 3.0 Video
Referência de topo em dinâmica de movimento e física de ambientes complexos. Excelente para planos abertos de cidades, multidões e simulação realista de fenómenos naturais como chuva, fumo e reflexos aquáticos.
O Guia Passo a Passo: O Workflow de 3 Estágios para Vídeos Perfeitos
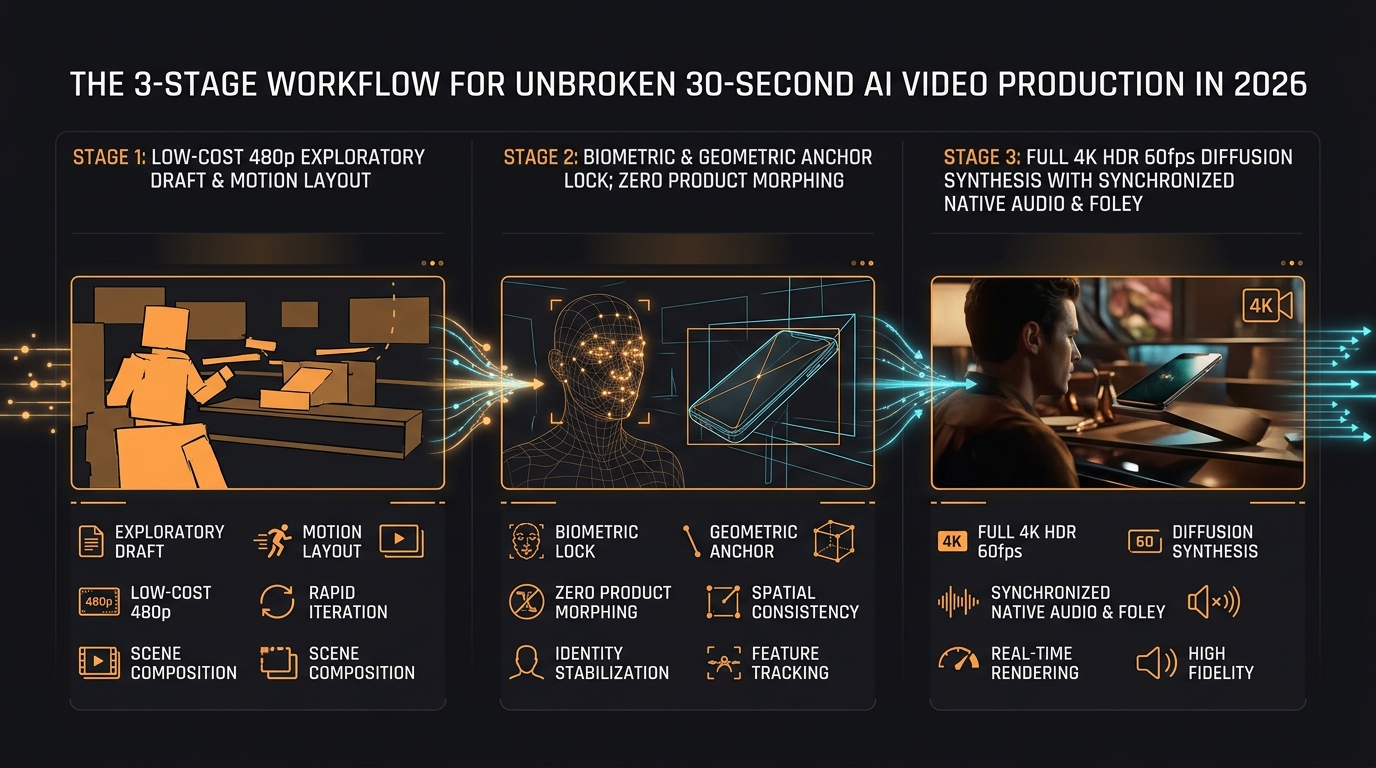
Muitos utilizadores cometem o erro de abrir um gerador de IA e pedir imediatamente um vídeo em 4K de 30 segundos a partir de texto. Esse método queima créditos, demora minutos e frequentemente falha o enquadramento desejado. Na DXBuilder, seguimos um pipeline estruturado e profissional:
Estágio 1: Rascunho Rápido de Movimento (480p Draft)
Antes de investir tempo em resoluções altas, valida a trajetória da câmara e a velocidade da ação. No estúdio da DXBuilder, podes gerar um rascunho de baixa resolução em menos de 10 segundos. É aqui que testas se a câmara deve fazer um travelling frontal, uma rotação orbital de 360 graus ou um plano picado. Se o movimento for o correto, avanças para o passo seguinte; se não for, ajustas o prompt sem custos significativos.
Estágio 2: Ancoragem de Identidade e Imagem Âncora (Identity & Product Lock)
Este é o segredo que separa amadores de profissionais: nunca faças Text-to-Video direto para produtos ou personagens recorrentes. Gera primeiro um fotograma âncora de altíssima definição no estúdio de imagem da DXBuilder (usando Nano Banana 2 ou GPT2). Este fotograma fixa a tipografia da embalagem, o reflexo do vidro, o corte de cabelo e as linhas faciais. A IA de vídeo utilizará este fotograma como restrição geométrica estrita.
Estágio 3: Difusão Contínua de 30s em 4K com Áudio e Foley Sincronizado
Com o movimento aprovado no Estágio 1 e a imagem âncora fixada no Estágio 2, injetas os materiais no motor Seedance 2.5 IR2V. O modelo sintetiza os 30 segundos contínuos com iluminação volumétrica e física de partículas realista, gerando em simultâneo os efeitos sonoros ambientais (o som da água a escorrer, o rolar dos pneus no asfalto molhado ou o eco de passos num pavilhão de betão).
Tabela Técnica: Especificações dos Motores de 30s em Outubro de 2026
Comparativo detalhado com dados empíricos recolhidos nas bancadas de teste da DXBuilder:
| Motor / Versão | Duração Máx. Nativa | Resolução Máx. | Áudio Integrado | Estabilidade de Objeto | Tempo de Render (30s) |
|---|---|---|---|---|---|
| Seedance 2.5 IR2V | 30s ininterruptos | 4K UHD (60fps) | Sim (Foley + SFX) | 9.9 / 10 (Multi-Ref) | ~45 segundos |
| Kling 4.0 Flash | 30s ininterruptos | 4K HDR (10-bit) | Sim (Ambiente estéreo) | 9.5 / 10 (10 Keyframes) | ~60 segundos |
| Wan 3.0 Video | 30s ininterruptos | 2.5K QHD | Parcial (Básico) | 9.1 / 10 (Física fluida) | ~75 segundos |
| MiniMax H3 Turbo | 15s - 20s | 1080p FHD | Sim (Voz + Foley) | 8.8 / 10 (Ação rápida) | < 15 segundos |
3 Fórmulas de Prompt Testadas para Vídeos de 30 Segundos Contínuos
Eis três estruturas de comando otimizadas para copiar e utilizar diretamente no estúdio de vídeo da DXBuilder:
Fotograma Âncora: "Ultra-sharp commercial studio still of a luxury matte dark bottle of cold-brew coffee sitting on a wet granite pedestal, golden amber backlight (#FF9B3E), tiny condensation droplets on the glass, razor-sharp 85mm lens, 8k resolution."
Comando de Movimento (30s): "Continuous unbroken 30-second camera sequence: Camera starts in an extreme macro close-up of condensation droplets sliding down the glass, slowly pulling back into a sweeping 360-degree orbital rotation while fresh roasted coffee beans tumble past in gentle slow motion. Lighting shifts smoothly from cool morning daylight to warm golden amber sunset. Native crisp sound of glass clinking, liquid pouring, and subtle studio ambience."
Fotograma Âncora: "Cinematic anamorphic still of a female researcher in a dark illuminated laboratory looking at a floating holographic energy sphere. 35mm lens, subtle optical flares, authentic skin textures, cool teal background with warm amber rim light."
Comando de Movimento (30s): "Unbroken 30-second continuous dolly shot: Camera glides slowly past glass servers and monitors towards her face as the holographic core expands and pulses with particle rings. She reaches out with her gloved hand at second 18, causing gentle light ripples to wash across her face. Realistic low hum of high-voltage machinery, synthetic electrical pulses, and gentle room reverb."
Fotograma Âncora: "First-person smartphone POV shot holding an ultra-sleek mechanical titanium pen over an open architectural sketchbook on a sunlit wooden desk. Crisp natural lighting, sharp focus on hands."
Comando de Movimento (30s): "Seamless 30-second first-person sequence: Hand unboxes the titanium pen, clicks the magnetic cap with a satisfying mechanical snap at second 4, smoothly draws a blueprint line across the paper while the camera shifts angle to reveal a 3D isometric sketch emerging from the page. Authentic tactile paper friction sounds, crisp metallic clicking, and natural ambient room audio."
Perguntas Frequentes Reais (People Also Ask)
Qual é a diferença entre gerar um vídeo de 30 segundos contínuos e juntar 6 vídeos de 5 segundos? ▼
A diferença reside na consistência latente. Quando geras clips separados de 5 segundos, cada geração reinicia as probabilidades da rede neural, originando pequenas alterações nas proporções do rosto, na cor do cabelo ou na posição dos objetos. Num vídeo nativo de 30 segundos contínuos (como no Seedance 2.5), a rede neural mantém o mesmo modelo tridimensional latente do início ao fim, garantindo que o sujeito e o cenário permanecem 100% idênticos.
O que é o modo Image-to-Video com imagem âncora e por que é essencial para 30 segundos? ▼
O modo Image-to-Video utiliza uma fotografia de alta definição como ponto de partida (fotograma 0). Em vez de pedir à IA que imagine um produto a partir de texto, o modelo recebe a geometria exata da embalagem, rótulos e cores. A IA apenas precisa de calcular a física do movimento e da luz, eliminando completamente as deformações visuais e distorções típicas de texto puro.
Como funciona a geração nativa de áudio e efeitos sonoros nos novos motores de vídeo? ▼
Os modelos modernos utilizam transformadores multimodais (Audio-Visual DiT) que correlacionam o movimento dos píxeis com frequências de som. Quando o modelo renderiza uma onda a bater numa rocha ou uma chávena a pousar numa mesa de vidro, gera simultaneamente a forma de onda sonora correspondente sincronizada ao milissegundo, eliminando a necessidade de sonoplastia manual em editores externos.
Preciso de uma placa gráfica potente para criar estes vídeos de 30 segundos na DXBuilder? ▼
Não. Todo o processamento computacional corre nos clusters neurais na nuvem da DXBuilder equipados com aceleradores H100 e B200. Podes aceder diretamente a partir de qualquer computador portátil, tablet ou smartphone através do navegador web e descarregar o ficheiro final em 4K sem sobreaquecer o teu dispositivo ou pagar faturas astronómicas de eletricidade.
Começa a Produzir no Estúdio DXBuilder Hoje Mesmo
Junta-te a mais de 1.500 criadores, marcas e realizadores que já criam comerciais de 30 segundos com física perfeita e áudio nativo diretamente no browser.
Filipe Heitor
Fundador & Arquiteto AIEngenheiro de produto, realizador e fundador da DXBuilder. Especialista na interseção entre difusão de vídeo contínuo em 30 segundos, pipelines multimodais de áudio e arquiteturas de criação cinematográfica escalável sem atrito físico.