O maior pesadelo de qualquer realizador a trabalhar com inteligência artificial generativa sempre foi a «lotaria do Text-to-Video (T2V)»: escrever um prompt detalhado e rezar para que o modelo adivinhe o ângulo exato da câmara, o timing de um olhar dramático ou a física realista de um pontapé de artes marciais. Em setembro de 2026, esse paradigma está oficialmente morto. A revolução do Vídeo-para-Vídeo (V2V) e da Transferência Neural de Movimento (Neural Motion Transfer) permite a qualquer criador usar uma simples gravação de smartphone de 5 segundos como «esqueleto cinético». Os modelos de difusão espaço-temporal (Seedance 2.0 IR2V e Wan 3.0) extraem a trajetória da câmara, a estimativa de profundidade e o fluxo ótico da tua gravação caseira, substituindo a pele, o cenário, o figurino e a iluminação por texturas cinematográficas 4K no padrão de lentes anamórficas de 35mm. O que antes custava 15.000€ em fatos de captura de movimento (MoCap) e semanas de modelação CGI 3D no Maya agora é executado em menos de 3 minutos no DXBuilder Video Studio por menos de 0,80€ em computação de GPU.
Definição Técnica: Vídeo-para-Vídeo Neural (Neural V2V) e Motion Transfer em 2026
O Vídeo-para-Vídeo Neural (V2V) é uma arquitetura de geração generativa condicional na qual um clipe de vídeo pré-existente fornece a orientação estrutural (fluxo ótico, vetores de velocidade, mapas de profundidade monocular como Depth Anything V2 e segmentação de contornos densos via SAM 3) para um modelo de difusão de transformadores (DiT). Em vez de sintetizar o movimento a partir de ruído aleatório guiado apenas por texto, o V2V re-injeta a dinâmica física real fotograma a fotograma no espaço latente. Isto permite ao realizador re-iluminar cenários, alterar vestuário, transformar atores em personagens fantásticas ou sintetizar sequências de ação acrobáticas complexas com 100% de consistência temporal e zero desintegração anatómica.
1. A Morte da «Lotaria do Prompt»: Por Que o Text-to-Video Falha na Realização Profissional
Se alguma vez tentaste gerar um plano cinematográfico complexo usando apenas palavras num prompt box, conheces a frustração. Escreves: «Câmara baixa em travelling rápido a acompanhar guerreiro que salta sobre destroços de betão, gira no ar e aterra empunhando uma katana cromada com iluminação de recorte âmbar». Carregas em gerar.
Na primeira tentativa, o guerreiro tem três pernas. Na segunda, a câmara decide fazer um zoom in inexplicável para o céu. Na décima tentativa, o movimento é fluido mas o guerreiro parece estar a flutuar no ar sem qualquer sensação de peso ou gravidade física. Ao fim de 40 gerações e 25€ em créditos queimados, acabas por aceitar um compromisso mediocre que não reflete a visão artística que tinhas na cabeça.
A razão técnica é incontornável: os modelos de difusão de vídeo são incrivelmente talentosos a inventar texturas, volumetrias e estilos fotográficos, mas não têm intuição espacial sobre marcação de atores (blocking), velocidade angular de giro de câmara ou contacto inercial com o chão. O cinema profissional vive de subtilezas de fração de segundo: a velocidade com que um olhar se desvia, a aceleração de um soco ou a desaceleração orgânica de um travelling com grua. Tentar descrever isso num parágrafo de texto é como tentar ditar uma partitura sinfónica de Beethoven por telefone.
É aqui que o Vídeo-para-Vídeo (V2V) destrói a lotaria. Em vez de tentares explicar a física à máquina, pegas no teu telemóvel, sais para a garagem ou para a sala, corres, viras a câmara na mão com o ritmo exato que queres, ou pedes a um amigo para simular a coreografia. Essa gravação amadora torna-se a armadura mecânica inquebrável sobre a qual o modelo de IA aplica o seu génio estético.
2. Como Funciona o V2V nos Bastidores em 2026: A Tríade de Condicionamento
Muitos criadores ainda confundem o V2V moderno com os velhos filtros de «estilização cartoon» de 2023, que simplesmente aplicavam uma camada de textura psicadélica que piscava a cada meio segundo. O V2V de setembro de 2026 opera a um nível computacional infinitamente mais sofisticado.
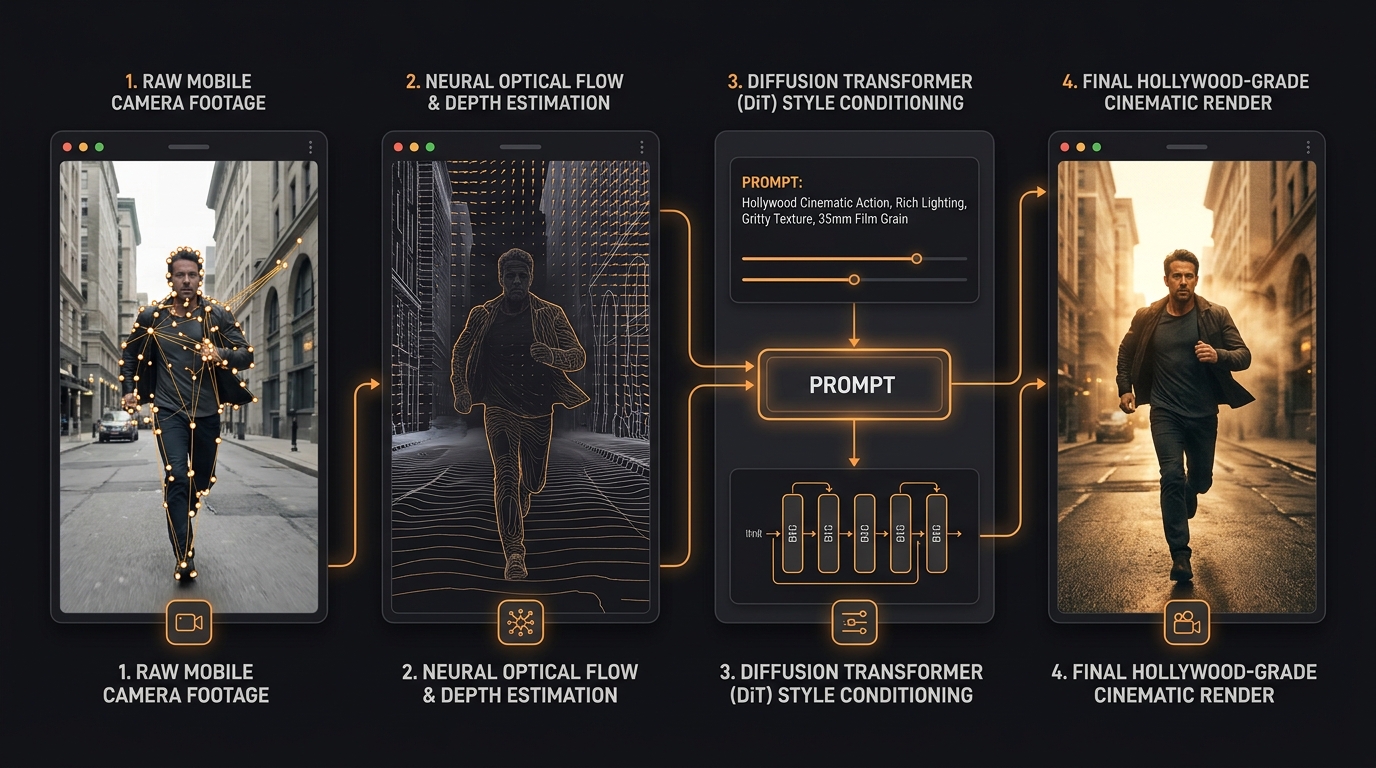
Quando carregas um vídeo de referência no Video Studio da DXBuilder utilizando o motor Seedance 2.0 IR2V ou Wan 3.0 V2V, o pipeline executa três passagens de desconstrução matemática em milissegundos:
O modelo calcula a distância exata de cada pixel em relação à lente virtual usando estimativas volumétricas. Isto cria uma malha tridimensional da cena, impedindo que os objetos de fundo se misturem com o corpo do ator.
Rastreia a velocidade e a aceleração de cada membro e da própria câmara entre cada fotograma. Se o teu braço se move a 2 metros por segundo, a IA sabe exatamente quanta aceleração e arrasto de movimento (motion blur) deve sintetizar.
Com a geometria e o movimento congelados, o transformador de difusão «descasca» a imagem original e repinta-a com base no teu prompt e nas tuas folhas de personagem do Character Studio (@Hero).
3. O Guia Prático Passo-a-Passo: Do Tejadilho da Garagem ao Cinema 4K
Nas minhas próprias produções na DXBuilder, usamos este pipeline quase diariamente para criar sequências de ação que seriam financeiramente impossíveis numa rodagem tradicional. Eis o protocolo exato que deves seguir para obter resultados fotorealistas de primeiro nível:
1 A Gravação do Vídeo de Rascunho (Scratch Footage)
Não precisas de uma câmara de cinema nem de tripés caros. O teu smartphone a 4K ou 1080p a 60fps é perfeito. O segredo está em três regras físicas simples:
- Velocidade de Obturador Alta: Evita gravações com demasiado arrasto de desfoque de movimento nativo (motion blur) na câmara do telemóvel. Se a tua mão ficar completamente borrada no vídeo bruto, o algoritmo de fluxo ótico terá dificuldade em isolar os dedos. Grava em locais bem iluminados com obturador rápido.
- Roupas Contrastantes: Se vais gravar numa sala com paredes brancas, usa uma camisola escura. Isto ajuda a segmentação neural a separar o teu corpo do fundo com precisão cirúrgica sem precisares de um ecrã verde.
- Movimentos de Câmara Deliberados: Se queres um travelling dramático de aproximação, anda fisicamente em direção ao ator. A aceleração humana do corpo transmite uma organicidade que nenhum comando de prompt de texto consegue fingir.
2 O Isolamento e Condicionamento no DXBuilder
No Video Studio, faz o upload do teu clipe de 5 a 10 segundos no módulo de entrada de referência de vídeo. Seleciona o preset de fidelidade cinética (Kinetic Match 85%).
Se o objetivo for manter o ator mas mudar o cenário (ex: transformar a tua sala de estar numa ponte de comando de uma nave espacial), ativa a opção Environment Swap. Se o objetivo for transformar uma vassoura que tens na mão numa espada laser de plasma ou num cajado medieval mágico, o modelo rastreia o objeto rígido e substitui a malha geométrica automaticamente.
3 A Regra de Ouro do Prompting em V2V: Descrever a Estética, Nunca o Movimento
Este é o erro número um que vejo 90% dos criadores cometerem: eles sobem um vídeo de alguém a correr e escrevem no prompt: «O homem corre para a esquerda enquanto olha para trás». Nunca faças isto!
O modelo V2V já está a ler a corrida e o olhar a partir dos píxeis do vídeo original. Se repetires a descrição do movimento no texto, a rede neural tenta reconciliar a ordem textual com a ordem cinética visual, gerando artefactos de duplicação, braços extras e distorções anatómicas. O teu prompt de texto em V2V deve focar-se exclusivamente na direção de arte, textura e luz:
4 Design Sonoro e Foley Neural de Impacto Sincronizado
Um plano de ação em V2V sem som não passa de um GIF bonito. No Audio Studio da DXBuilder, aproveitamos os próprios picos de velocidade do vídeo gerado para sintetizar Foley neural em perfeita sincronia temporal: os passos pesados no chão molhado, o roçar de tecido tático ou o estalar elétrico do impacto. Para a banda sonora, usamos o Music Studio para ancorar batidas percussivas nos momentos de corte do plano.
4. Tabela de Comparação Técnica: O Abismo Entre Métodos
Para compreenderes por que as agências de publicidade e estúdios independentes estão a migrar massivamente para fluxos de trabalho V2V, compara os três caminhos de produção audiovisual disponíveis em 2026:
| Critério de Produção | Text-to-Video Puro (T2V) | CGI 3D & MoCap Tradicional | AI Video-to-Video (V2V) |
|---|---|---|---|
| Controlo Exato de Câmara | Aleatório / Estatístico (30-40 tentativas para acertar o ângulo) | Total (Curvas de animação em Maya / Blender) | Determinístico 1:1 (segue o movimento manual do telemóvel) |
| Coreografia e Física Humana | Frequente perda de membros e flutuação antigravítica | Exige fatos de sensores óticos e limpeza manual de keyframes | Física biológica real preservada diretamente do ator |
| Tempo de Execução por Plano | 2 a 4 horas (prompting em loop iterativo) | 3 a 6 semanas (rigging, animação, iluminação, render) | 90 a 180 segundos no DXBuilder GPU Cluster |
| Custo Estimado por Cena | 15€ a 30€ em tokens de GPU desperdiçados | 8.000€ a 25.000€ em estúdio e equipa especializada | 0,75€ a 1,50€ em créditos DXBuilder |
| Equipamento Necessário | Browser Web | Fato Xsens/OptiTrack, workstation 128GB RAM, GPUs RTX 6000 | Qualquer smartphone moderno (iOS ou Android) |
| Consistência Facial do Ator | Distorção facial a cada novo plano | Excelente mas com risco de «Uncanny Valley» em 3D | Consistência absoluta através do Character Studio (@Hero) |
5. Três Fórmulas de Prompt V2V Prontas a Copiar para as Tuas Produções
Para acelerares o teu trabalho, preparei três estruturas de prompt comprovadas que utilizo nas minhas produções. Basta copiares o texto, fazeres upload do teu vídeo de smartphone no Video Studio e ajustares os detalhes estéticos:
[SUBJECT]: Gritty operative in tactical Kevlar body armor, weathered fabric texture, mud splatters, realistic determined facial expression.
[ENVIRONMENT]: Industrial warehouse interior at midnight, broken skylight with streaming moonlight and golden amber halogen spotlights (#FF9B3E), atmospheric dust motes and airborne debris suspended in slow motion.
[LIGHTING]: Heavy volumetric backlighting, deep moody shadows, high micro-contrast, natural specular reflections on wet concrete.
[TECHNICAL]: 35mm film grain, subtle halation around light sources, crisp edge definition, natural optical motion blur on moving limbs. [AUDIO: thunderous low-frequency impact, shattering glass, metallic gear rattle — NO dialogue]
Instrução de Gravação: Grava a ti próprio a fazer uma esquiva rápida ou um golpe com um cabo de vassoura. Mantém a câmara fixa ou com um pequeno movimento de chicotada (whip pan).
[SUBJECT]: Cybernetic courier wearing an illuminated translucent waterproof trench coat with fiber-optic wiring, subtle chrome mechanical implants on neck.
[ENVIRONMENT]: Densely populated futuristic megalopolis alleyway at dusk, neon holographic signage reflected in rain puddles, dense rising sewer steam.
[LIGHTING]: Anamorphic blue horizontal streaks, golden rim lighting, soft light diffusion through misty rain.
[TECHNICAL]: 8k photorealism, authentic skin pores, organic sweat droplets, zero digital plastic smoothing. [AUDIO: heavy rainfall, distant drone engine hum, electronic neon flicker]
Instrução de Gravação: Caminha na tua rua à noite com um casaco vulgar com o capuz levantado e olha para a câmara enquanto o telemóvel recua à tua frente.
[SUBJECT]: High-fashion model with striking features, wearing an architectural metallic silk evening gown that flows with organic wind turbulence.
[ENVIRONMENT]: Brutalist minimalist concrete museum gallery, floor-to-ceiling glass windows overlooking a stormy sea.
[LIGHTING]: Razor-sharp golden-hour side lighting through architecture, warm specular highlights on silk fabric weave, pristine clean whites.
[TECHNICAL]: Hasselblad medium format look, rich color depth, velvety shadow roll-off, elegant slow motion cadence. [AUDIO: rhythmic high-fashion electronic bass pulse, wind gust, rustling heavy silk]
Instrução de Gravação: Pede a alguém para girar sobre si próprio na sala de estar com um lençol ou xaile comum. O V2V substitui o lençol por seda de alta costura e a sala por um palácio brutalista.
6. O Impacto Comercial: Como Produtoras e Agências Estão a Monotizar o V2V
O maior equívoco é achar que o V2V serve apenas para criadores experimentais no YouTube ou no TikTok. Na prática corporativa diária da DXBuilder, estamos a ver três setores a lucrar diretamente com este pipeline:
Em vez de alugar estúdios de 5.000€/dia para filmar modelos com produtos, a equipa interna da agência grava os membros da sua própria equipa a segurar caixas vazias ou a usar roupas normais no escritório. Com o V2V, transformam esses vídeos em comerciais internacionais com modelos de elite em locais paradisíacos, reduzindo os prazos de entrega de 3 semanas para 24 horas.
Cenas de risco que antes exigiriam duplos profissionais, cabos de suspensão e seguros caríssimos podem ser rodadas com colchões de ginástica no chão da garagem e depois transfiguradas em quedas épicas de edifícios futuristas com física corporal impecável.
Músicos independentes gravam a sua própria performance no quarto com playback da canção sincronizado. No DXBuilder, convertem o quarto num palco de festival eletrónico com pirotecnia e luzes estroboscópicas, mantendo a sincronia labial e o ritmo da dança intactos.
7. Perguntas Frequentes (FAQ Técnico para Criadores)
Preciso de um telemóvel topo de gama ou câmara profissional para gravar o vídeo de referência?
Não. Qualquer smartphone dos últimos quatro anos (iPhone 12 ou superior, Samsung Galaxy recente, etc.) que grave a 1080p ou 4K a 30 ou 60 fotogramas por segundo é perfeitamente adequado. O modelo de IA não utiliza a textura nem a resolução do teu ficheiro original; utiliza apenas a malha vetorial de movimento e a profundidade relativa. O que importa é a estabilidade física do movimento e um contraste de iluminação razoável.
O V2V mantém a cara do ator original ou posso colocar um personagem completamente diferente?
Podes fazer as duas coisas. Se quiseres preservar os teus próprios traços faciais, ativas a retenção facial (Facial Lock). Se quiseres substituir o teu rosto por um ator digital específico que criaste no Character Studio da DXBuilder (@Hero), o motor faz a substituição biométrica completa, transplantando os olhos, mandíbula e expressões do personagem digital diretamente sobre a tua atuação original.
Como evitar o efeito de cintilação (flicker) e artefactos temporais nas roupas?
A cintilação acontece quando o modelo tenta re-inventar padrões textuais complexos (como xadrez fino ou riscas estreitas) a cada fotograma. Para eliminar o flicker: 1) Usa roupas lisas e de cor sólida no vídeo de referência; 2) No prompt, especifica materiais com propriedades de luz bem definidas (ex: «matte leather», «brushed aluminum», «heavy wool coat»); 3) No DXBuilder, mantém o parâmetro de consistência temporal ajustado acima de 0.82.
Quanto custa renderizar sequências V2V em comparação com o Text-to-Video tradicional?
No DXBuilder, o custo de GPU é praticamente idêntico ao de uma geração normal de vídeo de 5 a 10 segundos (cerca de 0,75€ a 1,20€ por plano com o motor Seedance 2.0 IR2V). No entanto, o custo efetivo total é 80% mais barato porque não desperdiças 20 gerações falhadas a tentar que a câmara ou o ator façam o movimento certo. Com o V2V, o primeiro ou segundo take é imediatamente utilizável na montagem final. Consulta os nossos pacotes no DXBuilder Pricing.
Escrito por Filipe Heitor
Fundador & Diretor Criativo da DXBuilder
Passou os últimos anos a desenvolver ferramentas de inteligência artificial generativa que devolvem o controlo autoral aos cineastas e criadores independentes. Se estás farto da lotaria do prompting e queres dirigir cenas com rigor de câmara e física real, experimenta o nosso Video Studio, desenha a tua narrativa no Story Lab e fixa o teu elenco no Character Studio.


