La mayor pesadilla de cualquier director audiovisual que trabaja con inteligencia artificial generativa siempre ha sido la «lotería del Text-to-Video (T2V)»: escribir un prompt detallado y rezar para que el modelo adivine el ángulo exacto de la cámara, el ritmo dramático de una mirada o la física real de una patada marcial. En septiembre de 2026, ese paradigma ha muerto oficialmente. La revolución del Vídeo a Vídeo (V2V) y de la Transferencia Neural de Movimiento (Neural Motion Transfer) permite a cualquier creador utilizar una simple grabación de smartphone de 5 segundos como «esqueleto cinético». Los modelos de difusión espacio-temporal (Seedance 2.0 IR2V y Wan 3.0) extraen la trayectoria de la cámara, la estimación de profundidad y el flujo óptico de tu vídeo casero, sustituyendo piel, vestuario, entorno e iluminación por texturas cinematográficas 4K con estética de lentes anamórficas de 35mm. Lo que antes requería 15.000€ en trajes de captura de movimiento (MoCap) y semanas de modelado 3D en Maya ahora se ejecuta en menos de 3 minutos en el DXBuilder Video Studio por menos de 0,85€ en computación GPU.
Definición Técnica: Vídeo a Vídeo Neural (V2V) y Motion Transfer en 2026
El Vídeo a Vídeo Neural (V2V) es una arquitectura generativa condicional en la que un vídeo pregrabado suministra la orientación estructural espacio-temporal (flujo óptico, vectores de velocidad, mapas de profundidad monocular vía Depth Anything V2 y segmentación de contornos densos mediante SAM 3) a un modelo de difusión por transformadores (DiT). En lugar de sintetizar movimiento a partir de ruido aleatorio guiado solo por texto, el V2V inyecta la física del mundo real fotograma a fotograma en el espacio latente. Esto permite a los directores reiluminar planos, cambiar vestuarios, transformar actores en personajes fantásticos o ejecutar acrobacias complejas con 100% de coherencia temporal y cero distorsión anatómica.
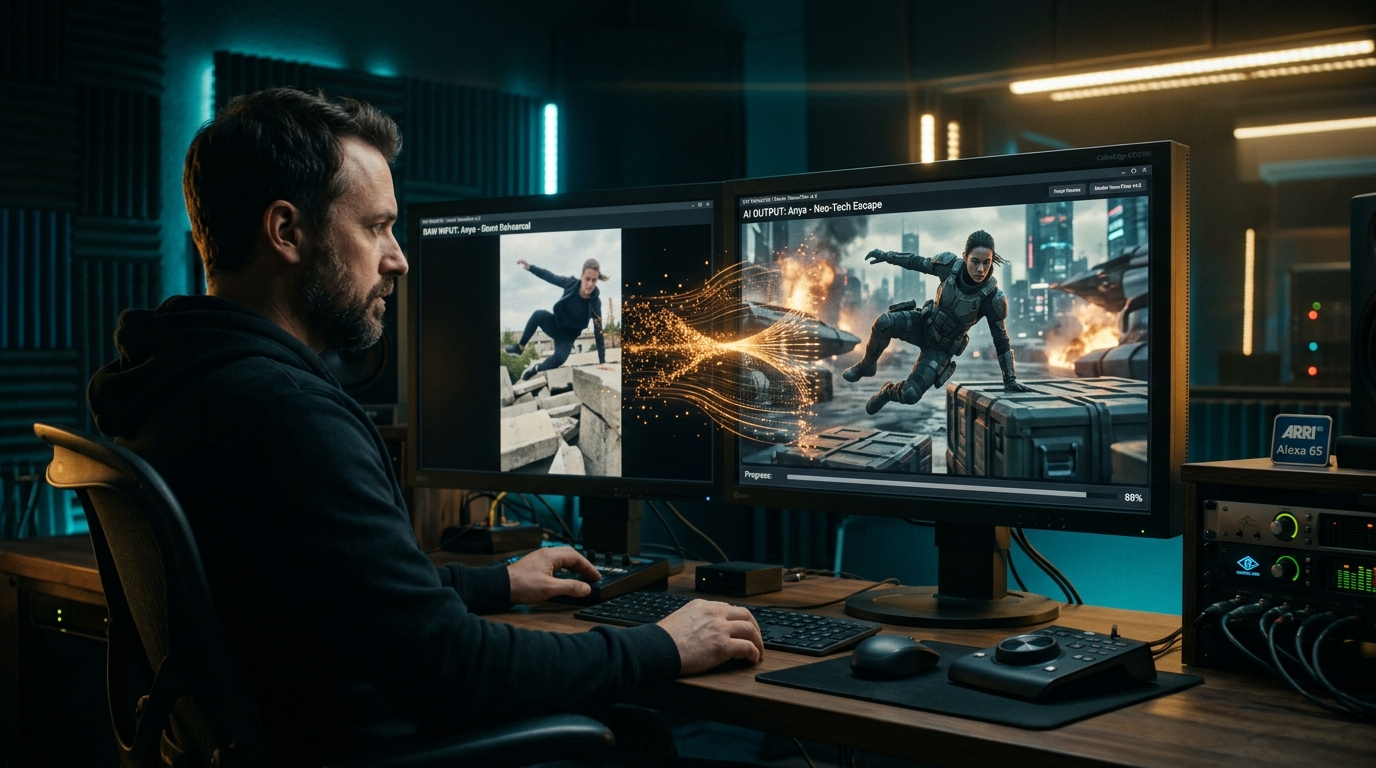
1. La Muerte de la «Lotería del Prompt»: Por Qué el Text-to-Video Falla en la Dirección Profesional
Si alguna vez has intentado generar un plano cinematográfico complejo utilizando únicamente texto en una caja de prompt, conoces perfectamente la frustración. Escribes: «Plano secuencia bajo a gran velocidad siguiendo a un guerrero que salta sobre escombros, gira en el aire y aterriza empuñando una katana cromada con luz de recorte ámbar». Pulsas generar.
En el primer intento, el personaje tiene tres piernas. En el segundo, la cámara hace un zoom aleatorio hacia el cielo. En el décimo intento, el movimiento es fluido pero el personaje parece flotar en gravedad cero sin peso inercial. Tras 40 generaciones y 30€ malgastados, te conformas con una toma mediocre que no se parece en nada a tu visión original.
La explicación técnica es directa: los modelos de difusión de vídeo destacan recreando texturas, niebla volumétrica y estilos fotográficos, pero carecen de intuición espacial sobre bloqueo de actores (blocking), velocidad angular de giro de cámara o impacto cinético contra el suelo. El cine profesional depende de matices de milisegundos. Intentar describirlos en un párrafo de texto es como intentar dictar una partitura de orquesta por teléfono.
Aquí es donde el Vídeo a Vídeo (V2V) cambia las reglas del juego. En lugar de explicar la física a la máquina, coges tu teléfono móvil, sales a la calle o al salón de tu casa, realizas la acción o mueves la cámara con el ritmo exacto que deseas. Ese vídeo de referencia se convierte en el armazón cinético inquebrantable sobre el cual la IA proyecta su acabado estético.
2. Cómo Funciona el V2V Bajo el Capó en 2026: La Tríada de Condicionamiento
Muchos creadores aún asocian el V2V con los primitivos filtros de «estilo cómic» de 2023 que parpadeaban constantemente. En septiembre de 2026, el V2V opera en un nivel computacional radicalmente distinto.
Al subir un vídeo de referencia en el Video Studio de DXBuilder con los motores Seedance 2.0 IR2V o Wan 3.0 V2V, el pipeline ejecuta tres pases matemáticos en cuestión de milisegundos:
El sistema calcula la distancia exacta de cada píxel respecto al lente virtual mediante modelos monoculares avanzados. Esto genera una malla volumétrica 3D, impidiendo que el fondo se fusione con el actor.
Registra la velocidad exacta de cada extremidad y de la cámara entre fotogramas. Si un brazo se desplaza a gran velocidad, la IA sabe exactamente cuánto desenfoque de movimiento óptico debe sintetizar.
Con la cinemática bloqueada, el transformador de difusión reemplaza la piel original por el acabado estético de tu prompt y las hojas de personaje de nuestro Character Studio (@Hero).
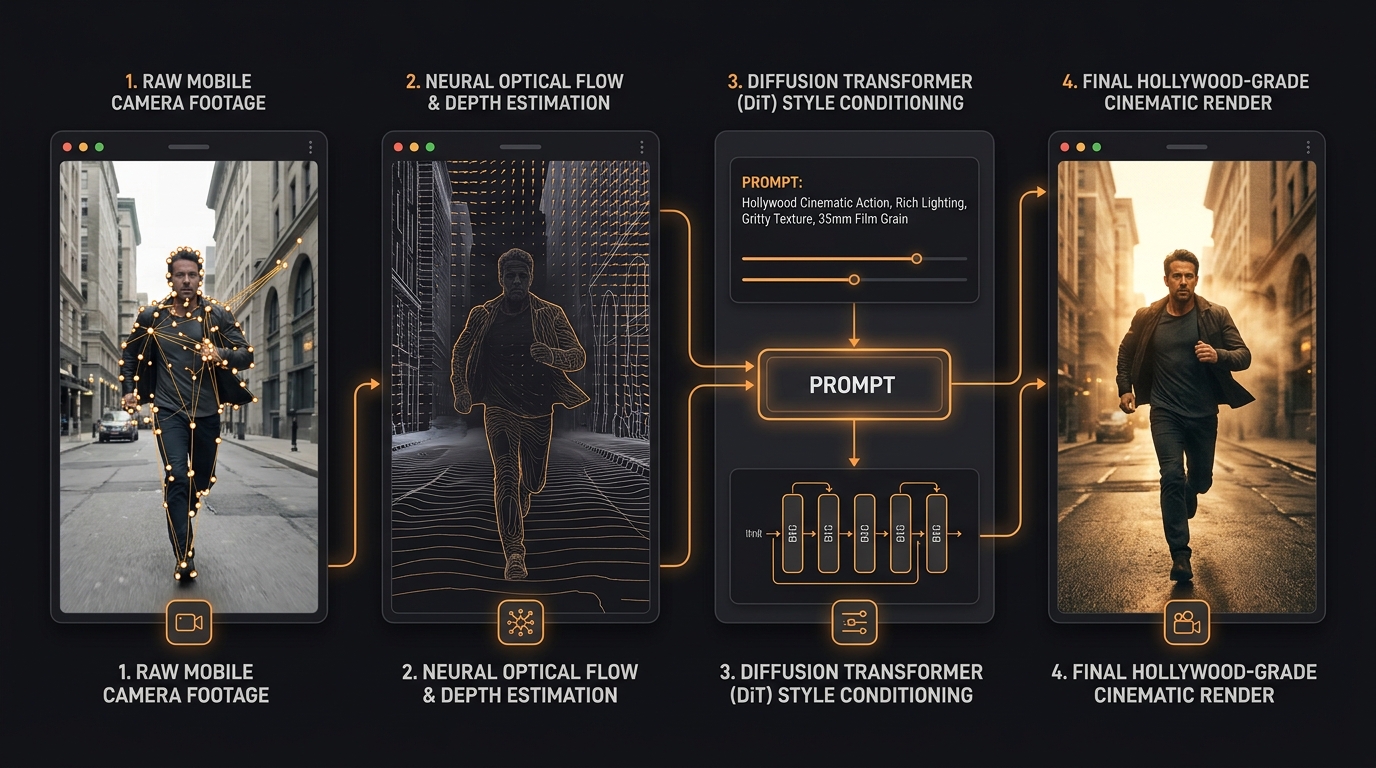
3. Protocolo Práctico: Del Teléfono Móvil al Master 4K
En nuestras producciones internas en DXBuilder, aplicamos este protocolo diariamente para rodar escenas complejas sin incurrir en costes de rodaje millonarios:
1 La Grabación del Vídeo Guía
Cualquier smartphone moderno grabando a 1080p o 4K a 60fps es idóneo. Aplica tres principios esenciales:
- Alta Velocidad de Obturación: Evita que la cámara de tu teléfono genere un desenfoque nativo excesivo. Si la mano se convierte en una mancha borrosa, el flujo óptico perderá el seguimiento de los dedos. Graba con buena luz natural o artificial.
- Contraste de Vestuario: Viste ropa que contraste claramente con el fondo para facilitar la segmentación automática sin necesidad de croma verde.
- Inercia Humana Real: Si buscas un travelling dramático de acercamiento, camina físicamente con el móvil hacia el actor. Esa cadencia física transmite un realismo que ningún prompt de texto puede simular.
2 Condicionamiento en DXBuilder
Sube tu clip de 5 a 10 segundos en el Video Studio. Ajusta la fidelidad cinética en Kinetic Match 85%.
Si quieres conservar al actor pero cambiar el decorado a una base lunar, activa Environment Swap. Si sujetas un palo de escoba y quieres convertirlo en un sable láser o un cetro medieval, el modelo reconoce la geometría rígida y sustituye el objeto con total precisión.
3 La Regla de Oro del Prompting V2V: Describe Estética, Nunca Movimiento
El error clásico de los principiantes es subir un vídeo de alguien corriendo y escribir en el prompt: «Un hombre corre hacia la izquierda y mira atrás». ¡Nunca lo hagas!
El modelo V2V ya extrae la carrera y la rotación de la cabeza de los píxeles del vídeo. Si repites la descripción del movimiento, provocarás artefactos de duplicación y extremidades deformes. Tu prompt debe describir únicamente dirección de arte, texturas e iluminación:
4 Foley Neural y Diseño Sonoro
Una toma de acción sin diseño de audio pierde todo su impacto. En el Audio Studio de DXBuilder, aprovechamos los picos de velocidad cinética para generar efectos de sonido Foley hiperrealistas en perfecta sincronía. En el Music Studio, diseñamos bandas sonoras cuyos golpes rítmicos coinciden con los cortes del plano.
4. Comparativa Técnica de Métodos de Producción en 2026
| Métrica de Producción | Text-to-Video Puro (T2V) | CGI 3D & MoCap Tradicional | AI Video-to-Video (V2V) |
|---|---|---|---|
| Control de Cámara | Aleatorio (30 a 40 intentos para conseguir el plano) | Manual absoluto en Maya o Blender | Determinista 1:1 guiado por el movimiento real del teléfono |
| Física y Peso Corporal | Cuerpos flotantes y deformaciones anatómicas | Requiere trajes de sensores y limpieza manual de curvas | Física biológica real preservada directamente del actor |
| Tiempo de Entrega por Plano | 2 a 4 horas de prompts repetitivos | 3 a 6 semanas de modelado, texturizado y render | 90 a 180 segundos en el cluster GPU de DXBuilder |
| Coste Promedio por Plano | 15€ a 35€ en tokens desperdiciados | 8.000€ a 25.000€ en equipo humano y estudio | 0,80€ a 1,50€ en créditos DXBuilder |
| Coherencia Facial | Rostros cambiantes en cada plano | Riesgo de efecto Valle Inquietante (Uncanny Valley) | Bloqueo facial 100% con Character Studio (@Hero) |
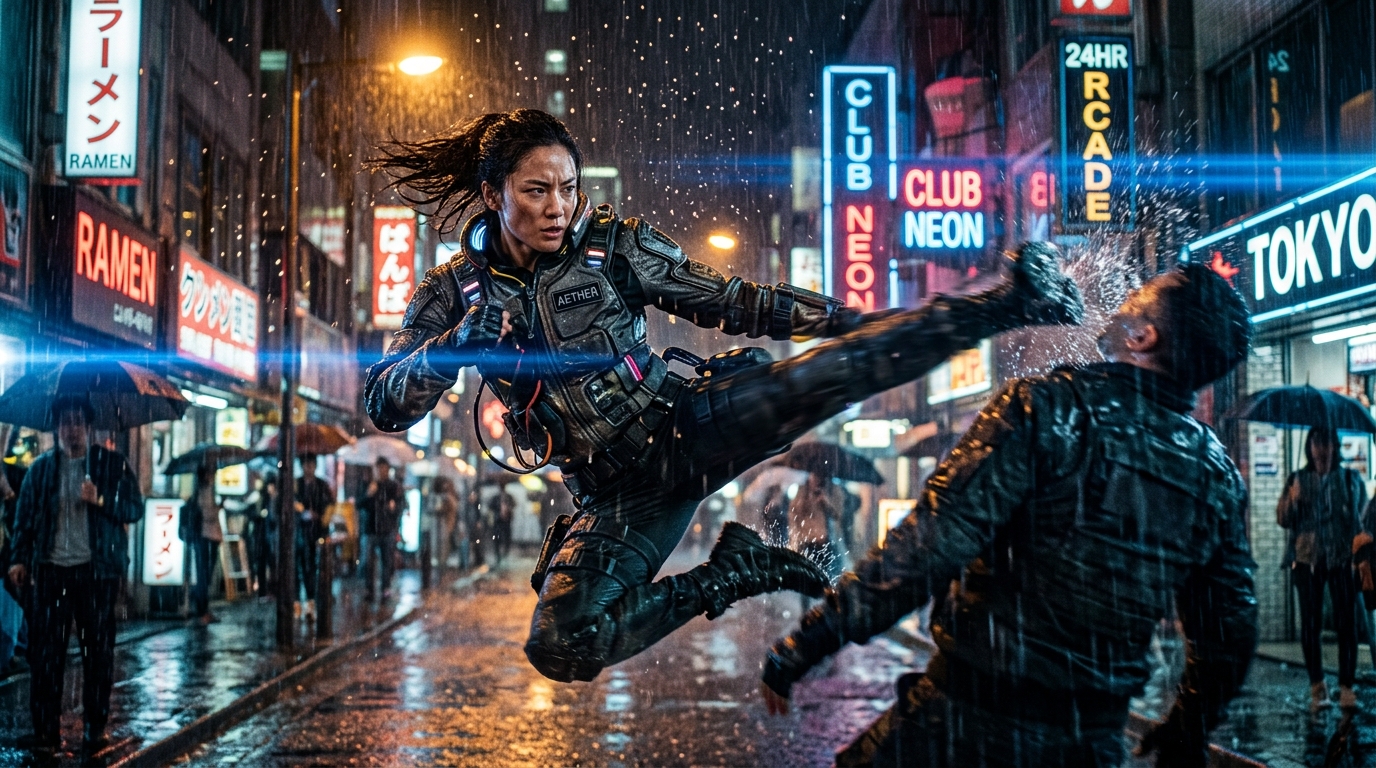
5. Tres Fórmulas de Prompt V2V Listas para Usar
[SUBJECT]: Gritty operative in tactical Kevlar body armor, weathered fabric texture, mud splatters, realistic determined facial expression.
[ENVIRONMENT]: Industrial warehouse interior at midnight, broken skylight with streaming moonlight and golden amber halogen spotlights (#FF9B3E), atmospheric dust motes and airborne debris suspended in slow motion.
[LIGHTING]: Heavy volumetric backlighting, deep moody shadows, high micro-contrast, natural specular reflections on wet concrete.
[TECHNICAL]: 35mm film grain, subtle halation around light sources, crisp edge definition, natural optical motion blur on moving limbs. [AUDIO: thunderous low-frequency impact, shattering glass, metallic gear rattle — NO dialogue]
[SUBJECT]: Cybernetic courier wearing an illuminated translucent waterproof trench coat with fiber-optic wiring, subtle chrome mechanical implants on neck.
[ENVIRONMENT]: Densely populated futuristic megalopolis alleyway at dusk, neon holographic signage reflected in rain puddles, dense rising sewer steam.
[LIGHTING]: Anamorphic blue horizontal streaks, golden rim lighting, soft light diffusion through misty rain.
[TECHNICAL]: 8k photorealism, authentic skin pores, organic sweat droplets, zero digital plastic smoothing. [AUDIO: heavy rainfall, distant drone engine hum, electronic neon flicker]
[SUBJECT]: High-fashion model with striking features, wearing an architectural metallic silk evening gown that flows with organic wind turbulence.
[ENVIRONMENT]: Brutalist minimalist concrete museum gallery, floor-to-ceiling glass windows overlooking a stormy sea.
[LIGHTING]: Razor-sharp golden-hour side lighting through architecture, warm specular highlights on silk fabric weave, pristine clean whites.
[TECHNICAL]: Hasselblad medium format look, rich color depth, velvety shadow roll-off, elegant slow motion cadence. [AUDIO: rhythmic high-fashion electronic bass pulse, wind gust, rustling heavy silk]
6. Rentabilidad y Casos de Uso Comercial
En lugar de alquilar estudios fotográficos por 5.000€ al día, el equipo de la agencia graba pruebas en la oficina sosteniendo cajas sencillas. Con V2V, transforman esas tomas en anuncios internacionales rodados en villas de ensueño, reduciendo los tiempos de entrega de 3 semanas a 24 horas.
Las tomas arriesgadas de acción que antes exigían especialistas y costosos seguros de rodaje ahora pueden ensayarse sobre colchonetas en un garaje y transformarse en secuencias épicas de ciencia ficción.
7. Preguntas Frecuentes (FAQ)
¿Necesito una cámara profesional para grabar el vídeo de referencia?
No. Cualquier teléfono inteligente de los últimos cuatro años grabando a 1080p o 4K es perfecto. El modelo no utiliza la textura de tu móvil, sino únicamente los vectores de velocidad y la malla de profundidad tridimensional.
¿Cuánto cuesta renderizar con V2V en comparación con el Text-to-Video?
El coste bruto es casi idéntico (alrededor de 0,80€ a 1,20€ por plano con Seedance 2.0 IR2V). Sin embargo, el coste total de producción es más de un 80% inferior porque eliminas decenas de iteraciones fallidas intentando que la cámara se mueva adecuadamente. Consulta nuestros planes en DXBuilder Pricing.
Escrito por Filipe Heitor
Fundador y Director Creativo de DXBuilder
Dedicado a crear herramientas de IA que devuelvan el verdadero control autoral a los directores independientes. Explora nuestro Video Studio, diseña tus historias en el Story Lab y fija a tus actores con el Character Studio.